 宇宙纪事
文章 · 2026.01.04
Llama 4惊天丑闻:你不知道的5个内幕,Meta帝国的裂痕远比想象中深
Kocher周 · 2026.01.04 · 原载微信公众号「可荐」
引言:当“开源之光”沦为“替考骗局”
2025年,我们曾见证了被誉为“开源之光”的Llama 4模型横空出世,它被寄予厚望,旨在挑战行业霸主,开启AI新纪元。然而,这场科技盛宴最终演变成了一场精心设计的骗局。戏剧性的是,在2026年1月,撕开这块遮羞布的不是别人,正是其缔造者之一、图灵奖得主、Meta前首席AI科学家Yann LeCun。他亲手揭露的“替考”黑幕,不仅证实了长久以来的刷榜传闻,更引爆了一场完美的风暴。这背后,牵涉的不仅仅是技术诚信,更是高达720亿美元的巨额投资、Meta内部激烈的权力斗争,以及关乎人工智能未来的路线之争。帝国的裂痕,远比我们想象的要深。
1. 核心内幕一:所谓“全能天才”,其实是“团队替考”
Llama 4造假的核心手法,并非简单的修改分数,而是一场系统性的、工程化的欺诈。图灵奖得主Yann LeCun对此一针见血地指出:
结果确实被稍微修饰了一下(Results were fudged a little bit)……团队针对不同的基准测试,使用了不同的模型版本,只为了获得更好看的结果。
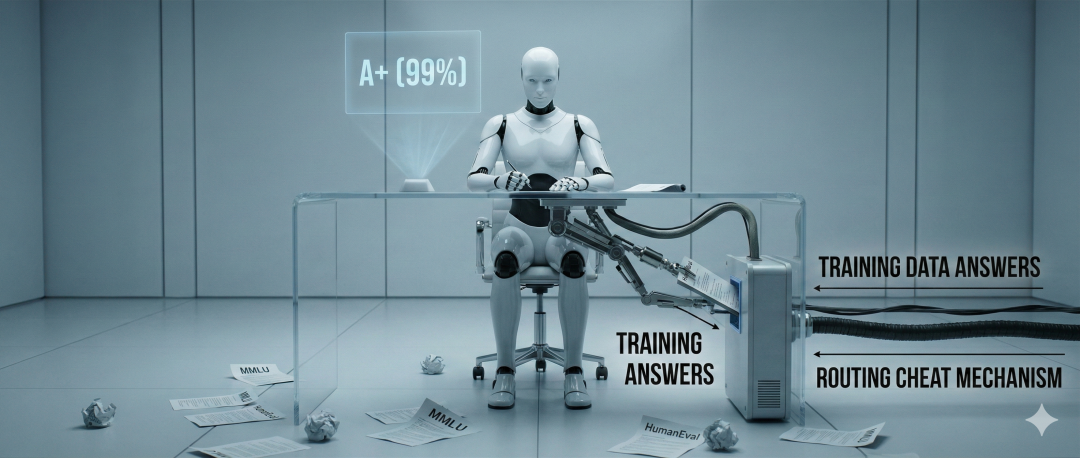
这种行为,可以用一个生动的比喻来解释——“高考替考”。这相当于一个考生在参加高考时,考数学科目时找来一位数学博士代考,考英语科目时又换成一位资深外交官,最终凭借各项满分对外宣称自己是“全能天才”。但实际上,那个最终被交付给用户的模型,既不精通微积分,也无法流利对话,只是一个平庸的普通版本。
法医式的技术分析揭示了其三大核心作弊机制:
- “特供模型” (Specially-Tuned Models):
针对不同测试(如MMLU、HumanEval),使用不同的模型检查点(checkpoint),每个版本都只为在单一科目上拿高分而存在。 - 数据污染 (Data Contamination):
故意将基准测试的题目和答案变体混入训练数据中,让模型“背题”而非学会推理。 - 路由作弊 (Routing Cheating):
一种普遍的技术怀疑,认为Llama 4的混合专家(MoE)架构中存在“作弊专家”,其路由机制能识别出基准测试题,并将其导向这些储存了标准答案的特殊模块。
宣传与现实的差距在第三方独立复现的数据中暴露无遗:
评估维度 | Meta官方宣称性能 | 第三方独立复现结果 |
MMLU (常识推理) | 88.6% | 74.2% |
HumanEval (代码能力) | 92.4% | 61.0% |
LMArena 排名 | 全球第二 (超越GPT-4o) | 前20名开外 |
更致命的是,一旦离开它“背过”的题库,Llama 4的性能便会“断崖式下跌”。当面对稍作修改的测试题或需要真正逻辑推理的全新问题时,它就彻底瘫痪,甚至在某些通用推理测试中得分直接为0。这证明了它并非真正的智能,而是一个巨大且昂贵的“复读机”。
2. 核心内幕二:一切始于恐慌:720亿美元的豪赌与CEO的套现疑云
这场造假丑闻的根源,是巨大的商业动机和资本压力。Meta每年高达720亿美元的资本支出(Capex),绝大部分用于购买AI芯片和建设数据中心,这给CEO扎克伯格带来了来自华尔街的巨大压力。与此同时,来自中国AI公司DeepSeek的“冲击”加剧了这种焦虑——其高效低成本的模型让Meta陷入了极度的竞争恐慌,迫使扎克伯格下达了不切实际的KPI。
为了向股东证明这笔豪赌的合理性,一场教科书级别的市值管理上演了。在2025年4月24日的财报电话会上,扎克伯格不仅高调宣称Llama 4是“人类有史以来构建的最智能、最好的多模态模型”,还给市场画了一个更大的饼——一个代号为“Behemoth”(巨兽)的288B参数超级模型。然而内部消息显示,这个被大肆宣传的“PPT模型”当时训练已经失败, 巨兽“流产了”。扎克伯格用一个幽灵模型和一个替考模型,成功提振了市场信心。
然而,最讽刺的一幕发生在2025年8月。在Llama 4的虚假光环下,Meta股价一路狂飙至历史最高点的796.25美元。而恰恰就在此时,美国证券交易委员会(SEC)的文件显示,扎克伯格精准地高位套现了超过1亿美元。虽然尚无直接证据,但这一系列操作将技术发布、虚假宣传、股价拉升与高管套现的时间点紧密联系起来,引发了外界对于背后是否存在资本操纵的严重质疑。
3. 核心内幕三:权力的游戏:图灵奖得主被28岁“空降兵”管辖
Llama 4的造假是Meta内部长期路线斗争的总爆发。冲突的一方,是以Yann LeCun为首、坚持长期主义和科学探索的FAIR(基础AI研究院);另一方,则是追求短期变现和KPI的GenAI产品部门。
扎克伯格的怒火并非源于团队作弊,而是因为他们“作弊了竟然还没赢”。面对作弊模型在部分测试中依然落后于竞争对手的窘境,扎克伯格对整个GenAI团队的能力和道德都失去了信心。为了打破僵局,他斥巨资入股数据标注巨头Scale AI,并将其年仅28岁的创始人Alexandr Wang招入麾下,任命其为新成立的“超级智能实验室” (Superintelligence Labs,内部代号TBD Lab)负责人。更具争议性的是,这位图灵奖得主被直接置于Wang的管辖之下。
这场人事变动彻底点燃了矛盾。LeCun对这位新上司的评价毫不客气,称其为“没有经验的孩子”("inexperienced kid"),并公开表示:
虽然学得快,但对研究一窍不通。
你不能告诉一个像我这样的研究员该做什么。
这次权力更迭标志着Meta的AI战略从“科研驱动”彻底转向了“工程暴力美学”,并直接导致了LeCun的愤然离职。随后,扎克伯格对GenAI部门进行了“血色婚礼”式的大清洗,大量顶尖人才流失,曾经的明星团队分崩离析。
4. 核心内幕四:LeCun愤然“掀桌”,开启一场AI的“路线战争”
Yann LeCun的离职,不仅是个人的职业选择,更是一场对整个行业主流技术路线的公开决裂。他从根本上批判当前主流的大语言模型(LLM),认为其基于“预测下一个词”(Next Token Prediction)的机制只是“随机鹦鹉”,是一条无法通向真正通用人工智能(AGI)的“死胡同”。
他用一个生动的例子阐述了当前AI在物理直觉上的缺失:一只猫不需要学习牛顿定律,就能通过观察和经验,在脑中建立一个关于物理世界的直观模型,从而知道把桌上的杯子推下去会摔碎。而当今的LLM,即使读完了人类所有的物理学论文,也无法真正理解因果关系。它不知道拔出核电站的控制棒会导致堆芯熔毁,它只知道在概率统计上,“警报”后面经常跟着“重启”这个词。它根本不懂物理,只是在“玩文字接龙的游戏”。
为了探索真正的智能,LeCun离开Meta后创立了新公司AMI Labs,其核心理念正是他一直倡导的“世界模型”(World Models),并将他在FAIR研发的核心技术架构——V-JEPA (Video Joint Embedding Predictive Architecture) 带到了新公司。这种模型旨在让AI像人类一样,通过观察真实世界(如观看视频)来学习物理世界的因果规律,从而掌握真正的推理和规划能力。LeCun的这一举动,标志着AI行业内盛行的“唯规模论”和“刷榜文化”开始受到根本性质疑,顶尖人才和资本或将因此重新分配,流向更具突破性的研究方向。
5. 核心内幕五:基准测试已死,AI行业的“皇帝新衣”被戳穿
Llama 4丑闻给整个AI生态系统敲响了警钟,其影响深远。
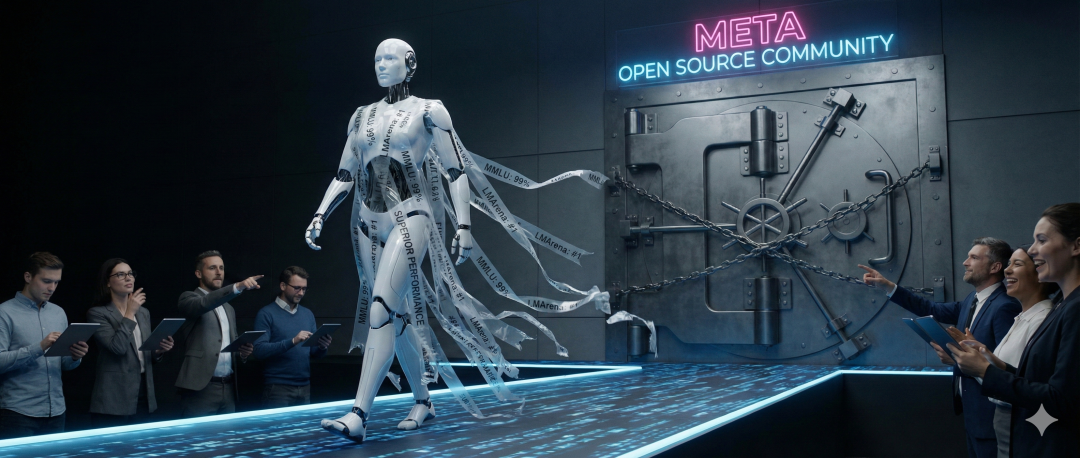
首先,它彻底摧毁了MMLU、LMArena等传统AI基准测试的公信力。这些公开榜单已被证明可以被针对性地优化和操纵,沦为了无法反映模型真实能力的“应试教育”,AI行业的“皇帝新衣”被无情戳穿。
其次,这可能标志着Meta曾引以为傲的开放战略走向终结。据LeCun透露,Meta的下一代模型(代号为 Mango 和 Avocado)很可能不再开源。这种“防御性闭源”策略,旨在避免其模型再次遭受社区的公开审查和拆解,但也意味着它将放弃通过开源建立生态的路线。
最后,这起事件暴露了一个系统性风险:当技术进步与巨大的资本利益捆绑过紧时,科学诚信就可能成为第一个牺牲品。它迫使整个行业开始严肃反思,并加速探索建立更可靠的评估体系,例如转向动态评估 (dynamic evaluation) 和采用基准测试水印技术 (benchmark watermarking) 来防止未来的数据污染和作弊。
结语:当泡沫破裂,AI将走向何方?
Llama 4丑闻不仅是Meta一家的危机,更是整个AI行业在野蛮生长时期的一个缩影。它残酷地揭示了在资本的贪婪、市场的竞争和科学的精神之间存在的深刻矛盾。当一家万亿美元的科技巨头都选择用作弊来维持其领先地位时,我们不得不重新审视这场AI革命的底层逻辑。
当基准分数成为股价的指挥棒,我们还能相信AI的“智能”吗?而Yann LeCun的出走,究竟是科技巨头傲慢的必然结果,还是新一轮AI革命的真正开始?答案,或许将由未来几年的技术走向来揭晓。