 宇宙纪事
深度专研 · 2026.01.30
【重磅】谷歌DeepMind的AlphaGenome发布:关于解码生命“暗物质”的5个惊人突破
Kocher周 · 2026.01.30 · 原载微信公众号「可荐」
前言:开启生命天书的新篇章在基因组学领域,一个长期存在的谜团困扰着科学家们:我们超过98%的DNA并不编码蛋白
前言:开启生命天书的新篇章
在基因组学领域,一个长期存在的谜团困扰着科学家们:我们超过98%的DNA并不编码蛋白质,曾一度被认为是“垃圾DNA”或生命的“暗物质”。然而,越来越多的证据表明,这片广阔的未知领域对我们的健康与疾病至关重要。理解这个“暗基因组”是一项巨大的挑战,但也是解开生命之谜的关键。
就在此时,谷歌DeepMind推出了AlphaGenome,一个革命性的人工智能模型,目标就是要最终破译这片遗传学的暗物质。它就像一台我们DNA的“实时编译模拟器”,不仅能读取基因序列,更能模拟和预测这些序列在细胞内的实际功能。
本文将为您剖析AlphaGenome带来的五个最具影响力的惊人突破。
------------------------------------------------------------------------
1. 它能读取我们DNA中的“暗物质”
我们98%的基因组是“非编码”的,而绝大多数与疾病相关的遗传变异都位于这些区域。长期以来,科学家们难以解读这些序列的功能,使得这部分基因组被称为“暗基因组”。
AlphaGenome正是为了照亮这片黑暗而生。它经过专门设计,旨在破译这98%的DNA,预测这些“调控基因组”中的变异如何影响它们所控制的基因的表达。简而言之,AlphaGenome的目标是系统性地破解生命的“暗物质”,让我们首次能够大规模地理解这部分基因组的功能。
2. 它解决了基因组学领域的“不可能三角”
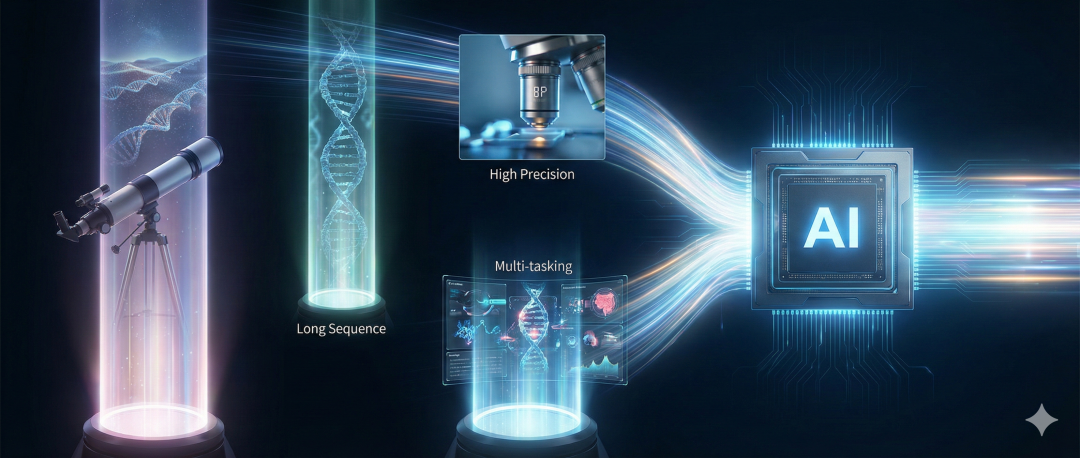
在AlphaGenome出现之前,基因组预测模型普遍面临一个“不可能三角”困境。这迫使研究人员陷入一个令人沮丧的选择:要么看到遗传学的森林却错过了单个树木,要么只能检查一片树叶却不了解它在森林中的位置。那些对复杂疾病至关重要的远距离基因相互作用,常常因此变得模糊不清,甚至完全看不见。模型必须在三个相互竞争的目标之间做出取舍:
- 长序列 (Long Sequence):
分析足够长的DNA片段以捕捉远程调控效应。 - 高精度 (High Precision):
以单个DNA碱基对的分辨率进行预测。 - 多任务 (Multi-tasking):
同时预测多种不同的生物学功能。
AlphaGenome通过其创新的混合架构一举攻克了这一难题。它能够处理长达100万个DNA碱基的序列,同时对其大部分预测任务保持单碱基对的超高分辨率。这得益于其采用的“U-Net + Transformer”混合架构,使其能够像一个既有广角视野又有微距功能的高清镜头,既能看到调控的“全景”,又能洞察单个碱基的“细微之处”。这项架构上的壮举本身就是一项工程奇迹,它需要系统将100万个碱基长度的序列分割到多个相互连接的AI芯片(TPU)上,让它们能够并行处理海量数据,同时又保持彼此通信以理解完整的上下文信息。
3. 它是遗传学家的“瑞士军刀”
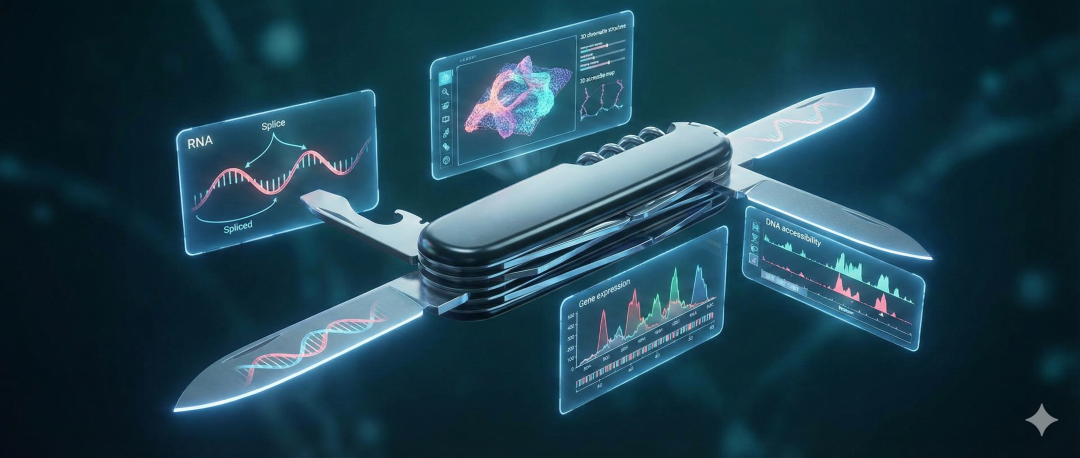
在过去,研究人员若想分析一个遗传变异可能带来的不同影响,通常需要使用多个专门的AI模型——一个用于预测剪接,另一个用于预测基因表达,等等。这个过程不仅繁琐,而且不同工具的结论还可能相互矛盾。
AlphaGenome改变了这一切。它是一个统一的多模态模型,只需输入一段DNA序列,就能同时预测超过11种不同类型、数千个具体指标的生物学过程。这包括基因活性水平、RNA剪接、DNA可及性、染色质三维结构(接触图谱)等。这种统一的方法极大地提升了效率,让科学家能够使用单一工具更快速地生成和检验科学假设。
正如西奈山伊坎医学院的人类遗传学家Judit García González所说:
“在AlphaGenome之前,研究人员‘可能需要使用三种具有各自局限性的不同工具,并且必须学习它们如何工作,才能预测大约20种不同的基因组功能后果。’现在,AlphaGenome将所有这些功能整合到了一个工具中。”
4. 它向一个“AI教师委员会”学习
AlphaGenome的训练过程极为巧妙,可以理解为一个两阶段的学习过程。
第一阶段是“预训练”。团队首先训练出多个大型的“教师模型”,让它们从海量的真实基因组实验数据中学习。
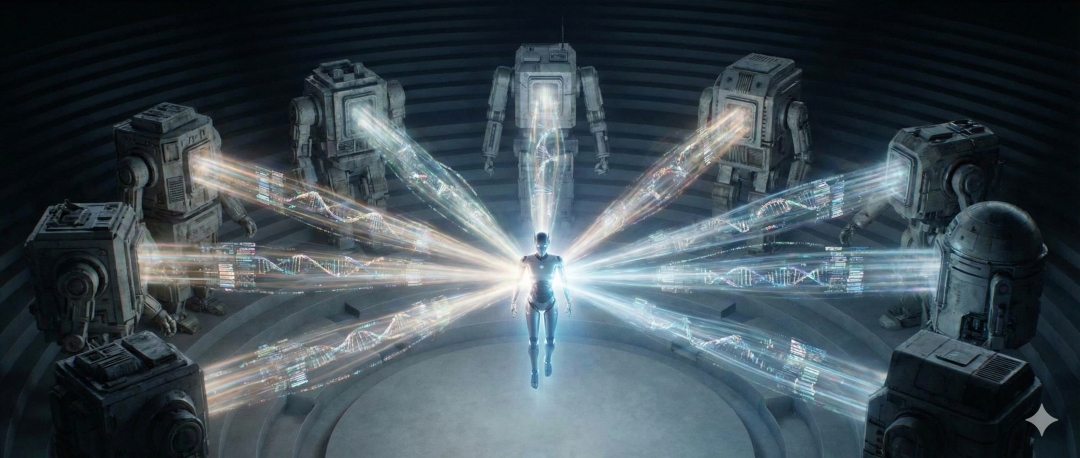
第二阶段是“知识蒸馏”。接着,团队训练一个更高效的“学生模型”,让它学习并重现“教师委员会”(由多个教师模型组成)的集体智慧和共识判断。
正如《科学新闻》(Science News)中的一个比喻所解释的:
“这就像让60位历史教授各自讲述一个重要事件……如果你考虑到所有历史学家都同意的共识,他们故事中的重叠部分,那很可能就是事实的真相。”
这一“蒸馏”过程至关重要,因为它将一个庞大而缓慢的“模型委员会”的共识智慧,浓缩到一个单一、闪电般快速的学生模型中,让研究人员对数百万遗传变异进行大规模分析在计算上成为可能。最终,评估一个遗传变异的影响耗时不到一秒。
5. 它将遗传疾病的“是什么”转变为“为什么”
AlphaGenome最强大的应用之一,是它能够超越仅仅识别变异与疾病之间的统计关联,进而预测导致疾病的具体生物学机制。
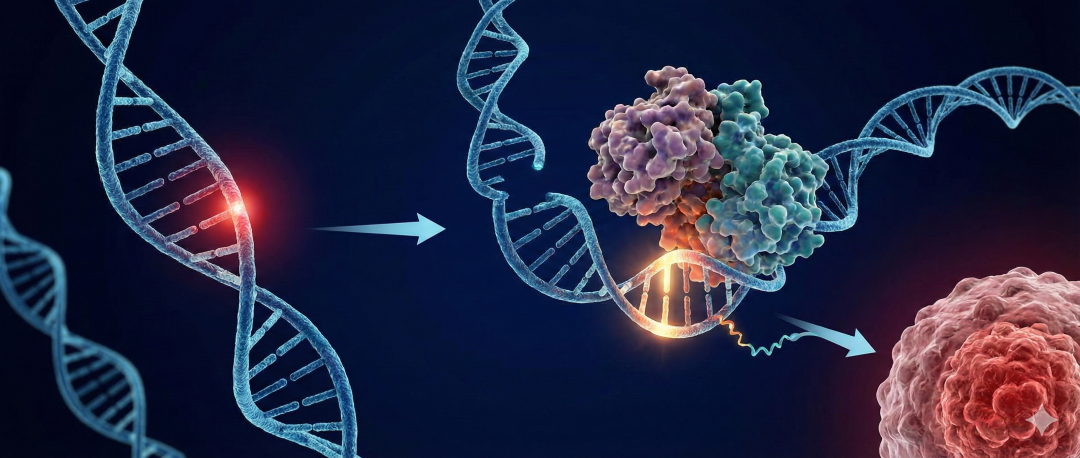
T细胞急性淋巴细胞白血病(T-ALL)的案例研究完美地证明了这一点。研究人员使用AlphaGenome分析了一些已知的非编码突变,这些突变会导致癌症但其作用机制尚不明确。模型不仅准确预测出这些突变会增加致癌基因TAL1的表达,更惊人地揭示了具体原因:这些突变在DNA上创造了一个全新的MYB转录因子结合位点,相当于为这个癌症基因凭空增加了一个“启动开关”。
伦敦大学学院的Marc Mansour教授对此评价道:
“AlphaGenome将成为该领域一个强大的工具。确定不同非编码变异的相关性可能极具挑战性,尤其是在大规模进行时。这个工具将提供解谜的关键一块,使我们能够更好地建立联系,以理解像癌症这样的疾病。”
这正是“暗物质”被照亮的方式——不仅仅是看到一个突变的存在,更是理解它所触发的精确事件链,将一个统计上的信号变成一个清晰的生物学故事。
------------------------------------------------------------------------
结论:从阅读到理解生命密码
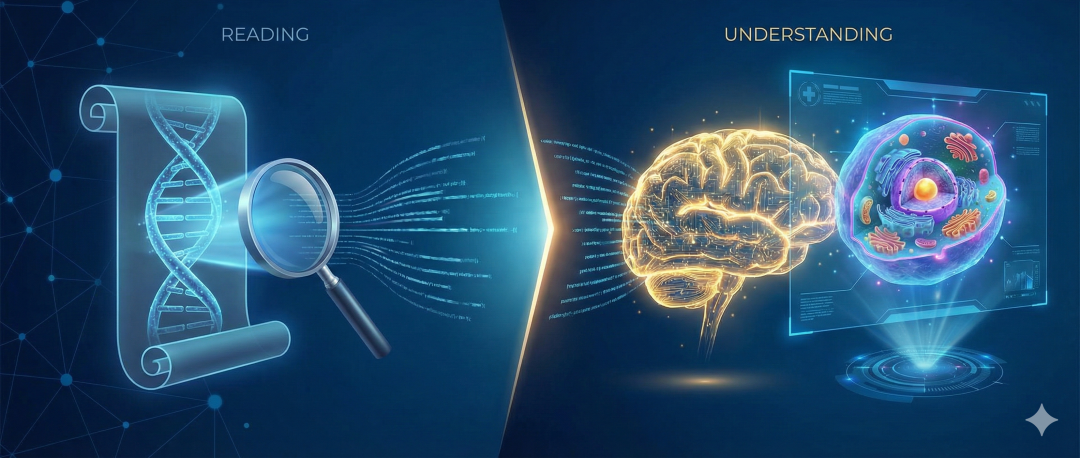
AlphaGenome代表了一场研究范式的转变——我们正从简单地阅读基因组的字母序列,迈向系统性地理解其背后复杂的调控逻辑。它标志着人工智能不再仅仅是数据分析的工具,而是正在成为科学发现本身的引擎。
当AI不仅能阅读,甚至开始模拟生命最底层的源代码时,我们不禁要思考一个深刻的问题:这将如何重新定义医学的未来,以及我们纠正导致疾病的“代码缺陷”的能力?