 宇宙纪事
文章 · 2026.02.01
中国AI芯片产业版图全景概览:从底层逻辑到大国博弈
Kocher周 · 2026.02.01 · 原载微信公众号「可荐」
2026年初,平头哥(T-Head)正式发布高性能AI训推芯片“真武810E”。这并非一次常规的硬件迭代,而是一个定义行业终局的里程碑。
#国产芯片 #阿里 #华为 #寒武纪 #产业链 #英伟达 #芯片禁令 #先进封装
1. 行业破局点:以平头哥“真武810E”看国产芯现状
2026年初,平头哥(T-Head)正式发布高性能AI训推芯片——“真武810E”。这并非一次常规的硬件迭代,而是一个定义行业终局的里程碑。真武810E在Llama2-70B测试中,首token延迟缩短至82毫秒(优于英伟达H20的95毫秒),吞吐量较H20提升18%。更具杀伤力的是其商业效率:通过自研架构与国产工艺协同,其单卡BOM成本下降约40%,彻底击穿了长期以来由英伟达主导的“算力税”定价体系。
此次发布的震撼核心在于100,000片的累计出货量(正冲刺300,000片年目标)。这一数字不仅超越了寒武纪等独立厂商,更是一场针对资本市场的“暴力验资”:它证明了国产高性能PPU(并行处理器)已跑通从“实验室模型”到“万卡智算集群”的工业化全链路。平头哥IPO前夕高达550亿美元(约3500亿人民币)的估值逻辑,正是基于“0.8倍寒武纪稀缺性溢价 + 3倍AWS式规模倍数”的复合定价——其背靠阿里内部确定的海量需求,提供了二级市场最渴求的“增长确定性”。
这种从单点突破到生态合围的态势,引导我们去审视:在先进制程受限的宏观背景下,中国半导体产业链是如何通过全环节的“非对称创新”实现突围的。
------------------------------------------------------------------------
2. 产业链全景图谱:从“沙子”到“云端”的价值链
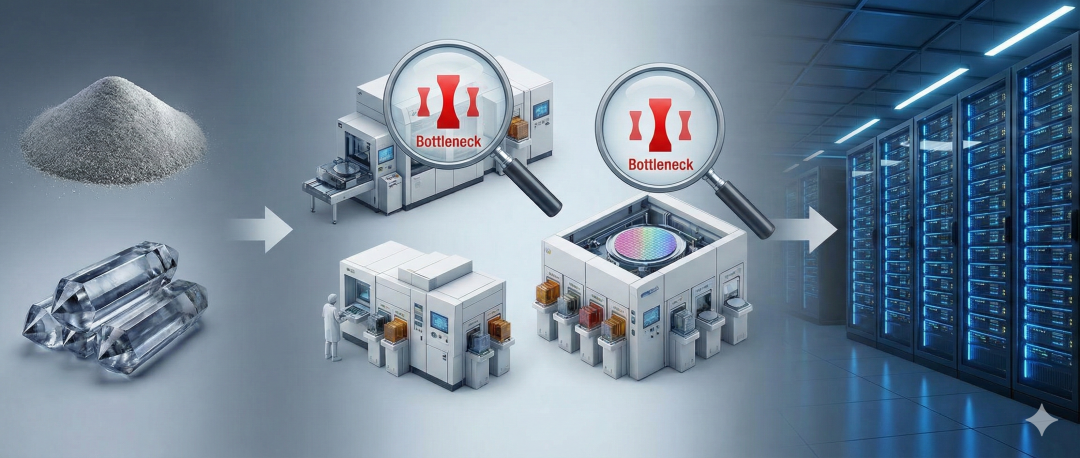
中国AI芯片产业正处于“木桶效应”的重塑期。虽然上游设备仍有痛点,但产业链整体韧性已今非昔比。
环节 | 核心角色 / 代表厂商 | 目前国产化率 / 瓶颈状态 |
上游:设计工具与设备 | 北方华创(设备平台)、中微公司(5nm刻蚀)、华大九天(EDA) | 设备国产化率约35%。关键瓶颈:光刻机(仅1%)、光刻胶(<5%)、EDA(11.5%,数字后端为短板)、HBM(0%起步,2026有望量产HBM3)。 |
中游:芯片设计与代工 | 设计: 华为昇腾、平头哥、寒武纪<br>代工: 中芯国际(N+2工艺)<br>封测: 长电科技、通富微电 | 设计端已实现对标;代工受限于DUV多重曝光工艺;先进封装(2.5D/CoWoS)产能紧缺,平头哥已锁定通富微电约20%的先进封装产能。 |
下游:应用部署与服务 | 阿里云、华为云、百度智能云、小鹏汽车、字节跳动 | 需求极度旺盛。大模型训练(万卡集群)和自动驾驶成为真实练兵场。字节跳动2025年资本开支预计达1500亿+。 |
这种上游受压、下游爆发的结构,倒逼中游设计厂商必须放弃传统的“暴力堆料”路径,转而从底层架构寻找生存的“降维武器”。
------------------------------------------------------------------------
3. 三大竞争派系:谁在主导中国算力战场?
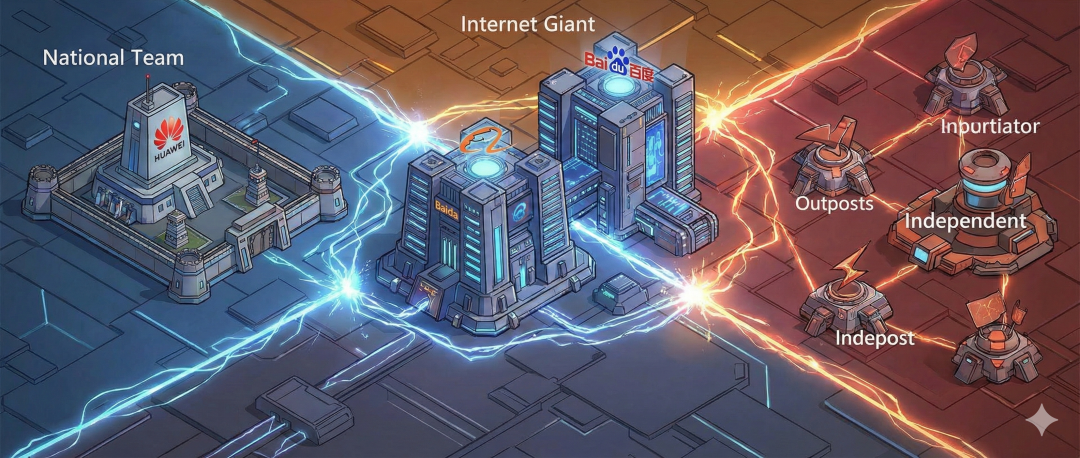
中国AI芯片赛道已演化为三种截然不同的生存哲学,决定了各方的量产命运与资本归宿。
- 🏆 国家队与行业中坚:华为昇腾(Huawei Ascend)
- 关键词:【全栈生态闭环】
华为凭借自研CANN软件栈、昇腾硬件及MindSpore,构建了类似苹果的软硬一体闭环。其CloudMatrix 384超节点(集成384颗910C)在DeepSeek推理测试中实现2300 tokens/s的超强吞吐。目前华为以23%的市占率稳居国产龙头。 - 💰 互联网巨头自研派:平头哥(阿里)、昆仑芯(百度)
- 关键词:【TCO总拥有成本优化】
逻辑是“自研自用”。通过自研PPU,阿里将算力成本降低55%-65%,实现了“印钞机”效应。百度昆仑芯则在搜索与自动驾驶领域通过XPU架构实现成本闭环,估值已超200亿。 - 🚀 独立芯片厂商:寒武纪、摩尔线程、壁仞等
- 关键词:【通用算力理想】
作为“全能选手”,他们致力于挑战GPGPU生态。寒武纪2025年业绩拐点确立,单季盈利突破3.5亿。然而,在缺乏“云干爹”支撑下,独立厂商面临极高的获客成本与毛利压力,未来可能面临被互联网巨头并购的命运。
派系之争的终局取决于技术路径的选择——尤其是能否在良率与性能之间找到“物理学最优解”。
------------------------------------------------------------------------
4. 技术路线之争:DSA架构的“降维打击”
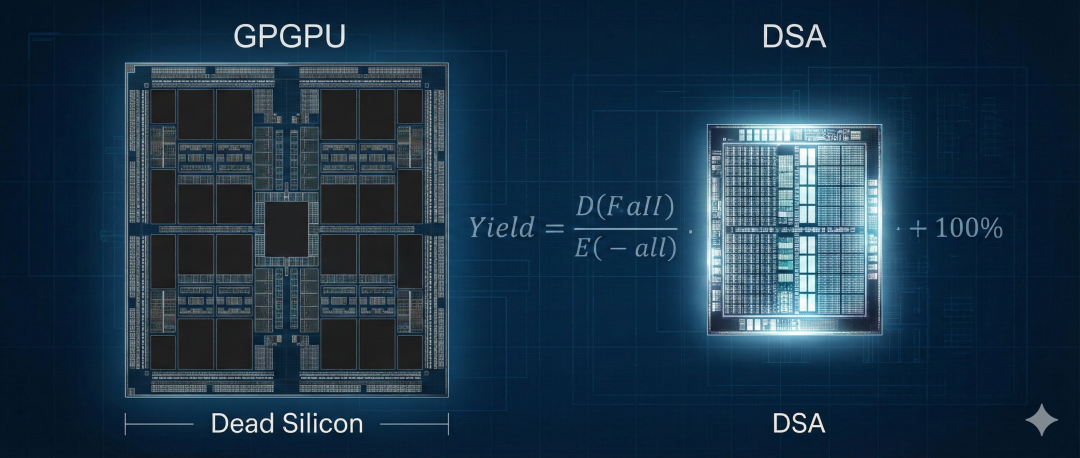
平头哥选择DSA(领域专用架构)GPGPU(通用图形处理器),本质上是一场物理统计学的胜利。
- 架构精简与良率逻辑:
芯片良率遵循公式 Yield \propto e^{-D_0 \cdot Area}。GPGPU为了兼容图形渲染,保留了大量在AI计算中毫无作用的“死硅(Dead Silicon)”,导致芯片面积巨大,缺陷概率随之指数级上升。DSA架构通过“做减法”,砍掉图形渲染单元,使芯片面积大幅缩小。在同等国产工艺节点下,DSA架构的合格切片数量(KGD)是GPGPU对手的2.7倍。 - 软件护城河——Halo编译器:
解决生态问题的关键在于“90/10规则”。平头哥的Halo编译器能自动翻译90%的通用算子;而剩下的10%极致性能算子,则通过上千名工程师的“暴力美学”进行人工重写。这种底层优化让小鹏汽车在迁移至真武平台后,模型训练效率提升了170倍。
在这种架构创新的护航下,国产芯片成功将制造工艺的短板转化为架构效率的长板,开启了“断供红利”的新篇章。
------------------------------------------------------------------------
5. 宏观叙事:从外部压力到“断供红利”的演变
外部管制的每一次升级,都在加速国产化率从“PPT阶段”向“工业化阶段”的跨越。
- 冲击期(2019-2022):
华为禁令开启了国产芯片的“概念验证”。市场份额仅10%-15%,此时的国产芯处于“敢看不敢用”的阶段。 - 适配期(2023-2025):H20禁令
成为转折点,英伟达特供版的性能阉割倒逼大厂测试国产芯。国产化率在2023年仅15%,到2025年飙升至40%以上。 - 红利期(2026-):
国产芯片进入“大规模工业化量产”。国产化率跨越50%分水岭。此时的决胜点已从单卡跑分转向集群稳定性:平头哥自研的HPN 2.0(高性能网络)通过“上帝视角”管控与双平面冗余,将万卡集群的MTBF(平均无故障时间)从4小时拉升至24小时以上。
随着集群能力的突破,行业也将从“百花齐放”进入惨烈的“优胜劣汰”。
------------------------------------------------------------------------
6. 未来推演:2027-2030的行业大洗牌
未来五年,中国AI芯片行业将经历从“资本泡沫”向“产业集中”的剧烈演变。
- 残酷洗牌:
2026-2027年将是独立GPU厂商的出清元年。缺乏大规模应用场景的公司,其芯片将沦为无法进入生产线的“电子垃圾”,面临破产或被大厂低价并购。 - 供应链突破:
预计2026年,长鑫存储在HBM3上实现量产突破,补齐高端显存的最后一块短板;国内封测厂在2.5D封装良率上将全面追近台积电CoWoS水平。 - 双系统格局:
最终形成“2-3家全栈头部(华为、阿里、百度)+ 若干细分领军者”的稳态,中国将拥有与全球体系并行、基于自研IP与国产工艺的独立算力闭环。
- 警惕“跑分冠军”:
孤立的单卡跑分毫无意义。无法跑通Halo编译器自动化适配或不支持HPN 2.0级网络拓扑的芯片,不具备大规模商业价值。 - 紧盯“资本底座”:
优先关注具有“云服务场景”背书的公司,其产品的快速迭代是靠真实业务数据喂出来的。 - 避开“GPGPU执念”:
在国产工艺追赶期,盲目追求CUDA全兼容往往意味着面积失控与良率崩盘,关注那些在DSA或PPU领域深耕的厂商。
------------------------------------------------------------------------
7. 结语:中国AI芯片的“工业化”新纪元
中国AI芯片已告别“讲故事”的初级阶段,正式进入硬碰硬的大规模工业化量产时代。从架构侧的良率突围到工程侧的集群优化,这场“百年未有之变局”正在重塑全球硬科技的底层逻辑。对于初学者而言,这不仅是理解技术的窗口,更是洞察大国竞争与资本脉络的绝佳教科书。
📖 核心术语对照表
缩写 | 全称 | 解释 |
EDA | Electronic Design Automation | 电子设计自动化,芯片设计的“画笔与尺子”。 |
DSA | Domain Specific Architecture | 专用领域架构,通过“减法”提升AI计算能效比。 |
PPU | Parallel Processing Unit | 平头哥定义的并行处理器,区别于传统通用GPU。 |
HPN 2.0 | High Performance Network | 阿里自研高性能网络,万卡集群的“神经系统”。 |
CoWoS | Chip on Wafer on Substrate | 先进封装技术,将计算核心与HBM显存“粘”在一起的关键。 |