 宇宙纪事
文章 · 2026.02.16
【前沿】仿真式 AI:为何 Karpathy 与李飞飞坚信“模拟”才是下一场范式革命?
Kocher周 · 2026.02.16 · 原载微信公众号「可荐」
#李飞飞 #Karpathy #仿真式AI #生成式AI #范式革命引言:从“猜谜”到“预见”的临界点在商业决
引言:从“猜谜”到“预见”的临界点
在商业决策的传统叙事中,决策者往往陷入一种代价高昂的“猜谜游戏”。无论是营销人揣摩 Z 世代对新包装的微妙反应,还是产品经理在海量功能建议中徘徊,传统的路径依赖于昂贵的 A/B 测试,或是在焦点小组中观察受试者的“表演”。由于霍桑效应(Hawthorne Effect)的存在,受试者往往因意识到被观察而选择性“撒谎”,导致真实需求被噪音淹没。
2026 年 2 月,斯坦福背景的初创公司 Simile Inc. 宣布完成 1 亿美元 A 轮融资,由 Index Ventures 领投,Andrej Karpathy 与李飞飞等 AI 巨头深度参与。这不仅是一家公司的崛起,更标志着 AI 产业的重心正发生结构性位移:从“生成内容”(Generative AI)跨越到“模拟行为”(Simulation AI)。我们正在进入“硅采样(Silicon Sampling)”时代,通过数以万计的数字孪生在虚拟沙盒中预演社会互动,从而在现实中“一次性做对”。
Takeaway 1: 预训练模型本质上是一个“仿真引擎”
Andrej Karpathy 对 Simile 的背书揭示了一个深刻的技术直觉:大语言模型(LLM)的初心并非聊天机器人,而是一个基于互联网海量人群文本训练出的社会仿真引擎。
他提出了“人灵(People Spirits)”或“幽灵(Ghosts)”的比喻:由于 LLM 是通过模仿人类数据而非生物进化来训练的,它们在统计学意义上展现出了类人的“涌现心理”。这并非在构建生物智能,而是在构建模仿人类行为概率分布的统计系统。
Karpathy 的 2026 洞察金句: “预训练大模型的原生、原始形态是一个仿真引擎。既然它拥有这种统计力量,为什么我们只用 AI 模拟‘一个人’,而不去尝试模拟‘整个群体’?”
这一视角将 AI 从单纯的“智能助理”推向了驱动企业决策的底层操作系统。
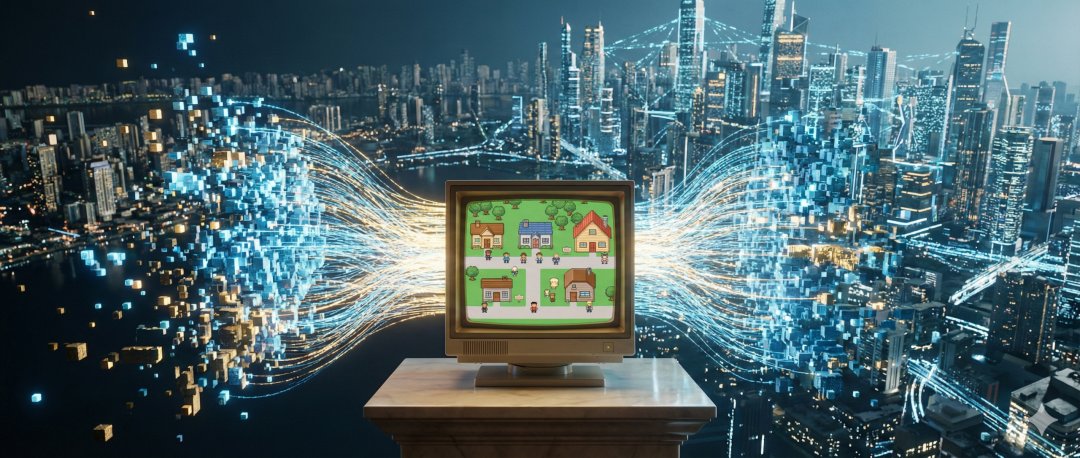
Takeaway 2: 从斯坦福“像素小镇”到 1 亿美元的商业野心
Simile 的技术基因直接溯源至著名的斯坦福 Smallville 实验。在那项实验中,25 个生成式智能体在没有预设程序的情况下,自发组织了情人节派对,证明了大规模社会行为涌现的可能性。
Simile 将这一学术原型进化为“高保真数字孪生”。其高达 5 亿美元的估值背后,是由顶级的学术大脑与商业推手构建的护城河:
- Joon Sung Park (CEO):
Smallville 论文第一作者,社会仿真领域的学术领航者。 - Percy Liang (首席科学家):
斯坦福基础模型研究中心 (CRFM) 负责人,AI 领域的学术脊梁。 - Michael Bernstein (CPO):
斯坦福副教授,深谙人机交互的核心逻辑。 - Lainie Yallen (CCO):
商业扩张的关键拼图。作为 Hebbia 的 8 号员工,她曾主导 15 倍的营收增长,并拥有将公司卖给 Roblox 的成功退出经验。
Takeaway 3: 给 AI 注入“灵魂”:记忆、反思与规划
仿真式 AI 为何能超越普通聊天机器人?关键在于它包裹在 LLM 之外的专有代理认知架构,这种架构被称为“软件 3.0”或决策支持基础设施。
- 记忆流(Memory Stream):
通过近因性、重要性和相关性评分检索。它能记住三个月前对某个品牌的糟糕体验,并在数周后的模拟中表现出抵触情绪。 - 反思(Reflection):
AI 会从碎片记忆中升华为高阶洞察。例如,当观察到智能体 Klaus 和 Maria 多次一起下棋、吃饭,系统会反思并生成一条新记忆:“Klaus 与 Maria 关系亲密”,而非仅仅记录动作。 - 规划(Planning):
递归式规划让 AI 具有目标导向,而非随机游走。它可以预演一个用户从浏览、对比价格到最终流失的完整动态路径。
特性 | 传统聊天机器人 (Stateless) | 仿真智能体 (Persistent) |
连贯性 | 仅限于上下文窗口,易遗忘 | 拥有长期“记忆流”,跨越数月不走样 |
认知深度 | 依赖提示词设定(单纯扮演) | 通过“反思”层自发形成价值观与性格 |
行为逻辑 | 随机、概率性的单次响应 | 目标导向,具备递归且可被打断的规划能力 |
Takeaway 4: 1400 亿美金调研行业的“推土机”
仿真式 AI 正在对全球规模达 1400 亿美元的市场调研行业实施降维打击。MIT 经济学家 John Horton 将这种新型仿真主体称为“Homo Silicus(硅人)”。
传统调研耗时 6-12 周、成本动辄数万美元。而 Simile 倡导的“硅采样”则能让企业在沙盒中进行成千上万次预演。到 2034 年,代理式 AI 市场预计将达到 1390 亿至 1990 亿美元的规模。
- CVS Health:
利用数十万个仿真客户,测试 9,000 多家药店的布局改动,模拟老年患者对复杂 App 界面的真实反应。 - Telstra 与 Wealthfront:
在新产品上线前,通过模拟全澳大利亚不同背景的数字孪生,预演客服中心的压力峰值。 - 财报预演:
某 CFO 曾利用 Simile 预测了分析师在电话会议中提出的 10 个问题中的 8 个。
这种效率的提升引发了“杰文斯悖论(Jevons Paradox)”:当研究成本大幅下降时,企业并不会减少投入,反而会创造出前所未有的海量调研需求。
Takeaway 5: 仿真工程——在“沙盒”里试错 1000 次
这不仅是工具的更迭,更是一种名为“仿真工程(Simulation Engineering)”的新范式。
生成式 AI 的价值在于“大规模生产”,而仿真式 AI 的核心逻辑在于“大规模筛选”:先在沙盒中模拟 1,000 次决策路径,找到那 1% 的最优解,从而在现实中“一次性做对”。
这种能力正迅速从营销领域扩展至全球地缘竞争:
- 规模跃迁:
相比 Smallville 的 25 个代理,AgentTorch 框架已实现 860 万代理的规模模拟,GenSim 平台则支持 10 万级代理的错误校正。 - 大国博弈:
中国已将人口仿真纳入国家基础设施,清华大学开发的 AgentSociety 平台致力于模拟 population-scale 的社会动态。中国《2035 战略》明确将 AI 仿真能力与社会治理深度绑定。
警示与挑战:算法“谄媚”与 94% 的多样性缺失
作为睿智的观察者,必须直面仿真AI的技术鸿沟。
核心风险与验证差距
- 单步与多步的断裂:
虽然在 GSS 社会调查复制中 AI 达到了 85% 的惊人准确率,但在多轮行为预测实验中,其准确率会骤降至 11.86%。单次响应的可信度不代表长期行为的准确性。 - 多样性塌缩:
研究显示,LLM 生成响应的多样性比人类低 93.9%。算法倾向于“平均值”,导致 tail risks(长尾风险)和少数派声音被抹除。 - WEIRD 数据偏见:
训练数据过度依赖西方(Western)、受教育(Educated)、工业化(Industrialized)、富有(Rich)、民主(Democratic)样本,导致其在非西方人群模拟中存在严重误差。 - 数字知情权:
当你的历史交易和访谈数据被克隆成一个“行为数字孪生”,该克隆体所产生的商业价值是否应归你所有?
结语:当统计学征服人类直觉
仿真式 AI 不仅仅是一个新工具,它正成为 AI 栈(AI Stack)中的新平台层。2026-2028 年将是企业级“影子世界”爆发的窗口期,大公司将习惯于在所有战略执行前,先在平行宇宙中跑一遍数据。
然而,当统计学彻底征服直觉,当仿真结果比真实测试更廉价且更具说服力时,我们必须保持警惕。杰文斯悖论告诉我们需求会激增,但它没有告诉我们,当世界被模拟出的“必然性”充斥时,那些混乱、非理性且不可预测的人性微光,是否会成为这个时代最昂贵的奢侈品。毕竟,我们不应只生活在黑客帝国的预演中。