 宇宙纪事
深度专研 · 2026.03.05
【重磅深度】万字长文:Dario Amodei的“指数级警告”与2026年AI算力、智能体及缩放定律的全面重构分析
Kocher周 · 2026.03.05 · 原载微信公众号「可荐」
“我们正处于某种不可思议之事的悬崖边缘。今年将发生一场让所有人震惊的彻底加速。我们没有看到任何‘撞墙’的迹象。指数级增长会让人们措手不及……即便是那些正试图在直觉上为之做好准备的人。”
引言
“我们正处于某种不可思议之事的悬崖边缘。今年将发生一场让所有人震惊的彻底加速。我们没有看到任何‘撞墙’的迹象。指数级增长会让人们措手不及……即便是那些正试图在直觉上为之做好准备的人。”
在2026年3月初举行的摩根士丹利TMT(科技、媒体和电信)大会上,Anthropic首席执行官Dario Amodei发表了上述令人不寒而栗却又极具号召力的断言。在这场汇聚了全球顶尖投资人和科技巨头的闭门会议中,Amodei的这番话并非硅谷常见的商业营销口号,而是基于整个AI产业在2026年第一季度所展现出的恐怖技术爆发力所做出的冷峻研判。当外界还在为大模型是否会因为“高质量人类数据枯竭”而陷入停滞(即所谓的“撞墙论”)争论不休时,前沿实验室和底层硅基硬件供应商已经通过全新的技术路径,彻底打破了线性发展的地心引力。
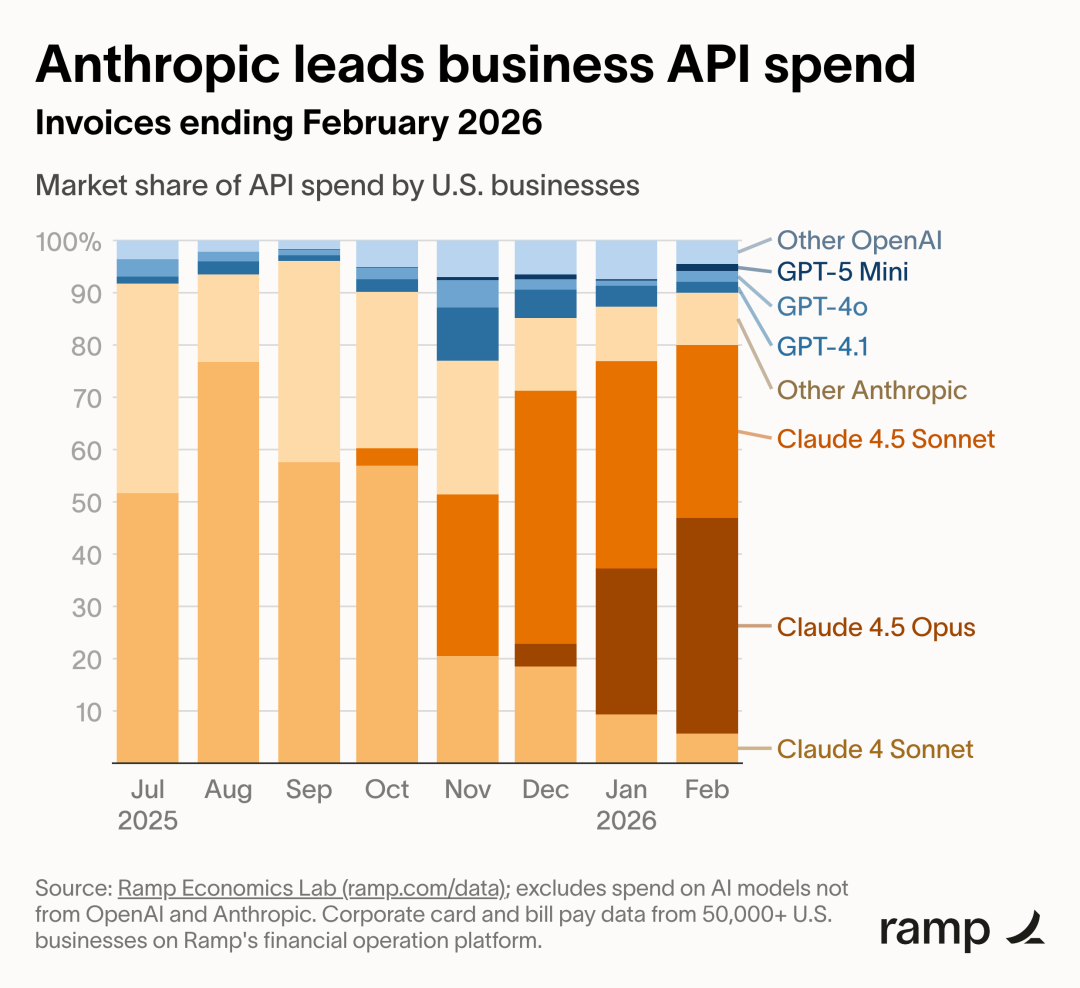
在会议期间,一个关于Anthropic年度经常性收入(ARR)已达到惊人的190亿美元的传闻不胫而走,尽管随后被澄清这仅仅是会议主持人在开场白中抛出的未经证实的数据,并非Amodei本人的官方声明
这种商业上的狂飙突进,本质上是底层技术能力突破临界点的副产品。2026年的春天,我们见证了Scaling Law(缩放定律)的二次进化、智能体(Agent)范式的全面落地,以及以Nvidia Vera Rubin架构为代表的算力基础设施的暴力革命。
本文将结合最新的科技发展现状,深度解构Amodei的“指数级警告”,全景式展现这场即将重塑人类商业与社会底层逻辑的技术海啸。
一、跨越“撞墙”错觉:缩放定律(Scaling Laws)的二次进化与测试时算力
要深刻理解Amodei所说的“没有看到任何撞墙的迹象”
正是基于这一法则,过去几年间,科技巨头们疯狂囤积GPU并搜刮互联网上的每一寸文本数据。然而,这也催生了怀疑论者的“撞墙论”——地球上高质量的文本数据即将耗尽,算力集群的能耗正逼近物理和经济极限,AI的智商似乎即将触及天花板。为了应对数据获取的挑战,巨头们甚至开始采取激进的版权采购策略。例如,Meta Platforms同意每年向新闻集团(News Corp)支付高达5000万美元的费用,以获取其美国和英国版新鲜及存档文章的授权,用于训练其AI模型并让聊天机器人提取实时新闻片段,这凸显了在AI竞赛中经过验证的高质量新闻数据的稀缺性与高昂价值
然而,2026年的前沿研究彻底打破了这种悲观预期。AI发展并没有撞墙,而是开辟了第二条甚至第三条指数级增长的曲线:测试时算力(Test-Time Compute)或推理期缩放定律(Inference Scaling)。
随着OpenAI的o1、o3以及DeepSeek的R1等推理模型的崛起,AI开发工具箱中增加了一个关键变量
在极端情况下,我们可以允许模型思考数分钟,在后台生成数十页的文本,以攻克极度复杂的数学或工程难题
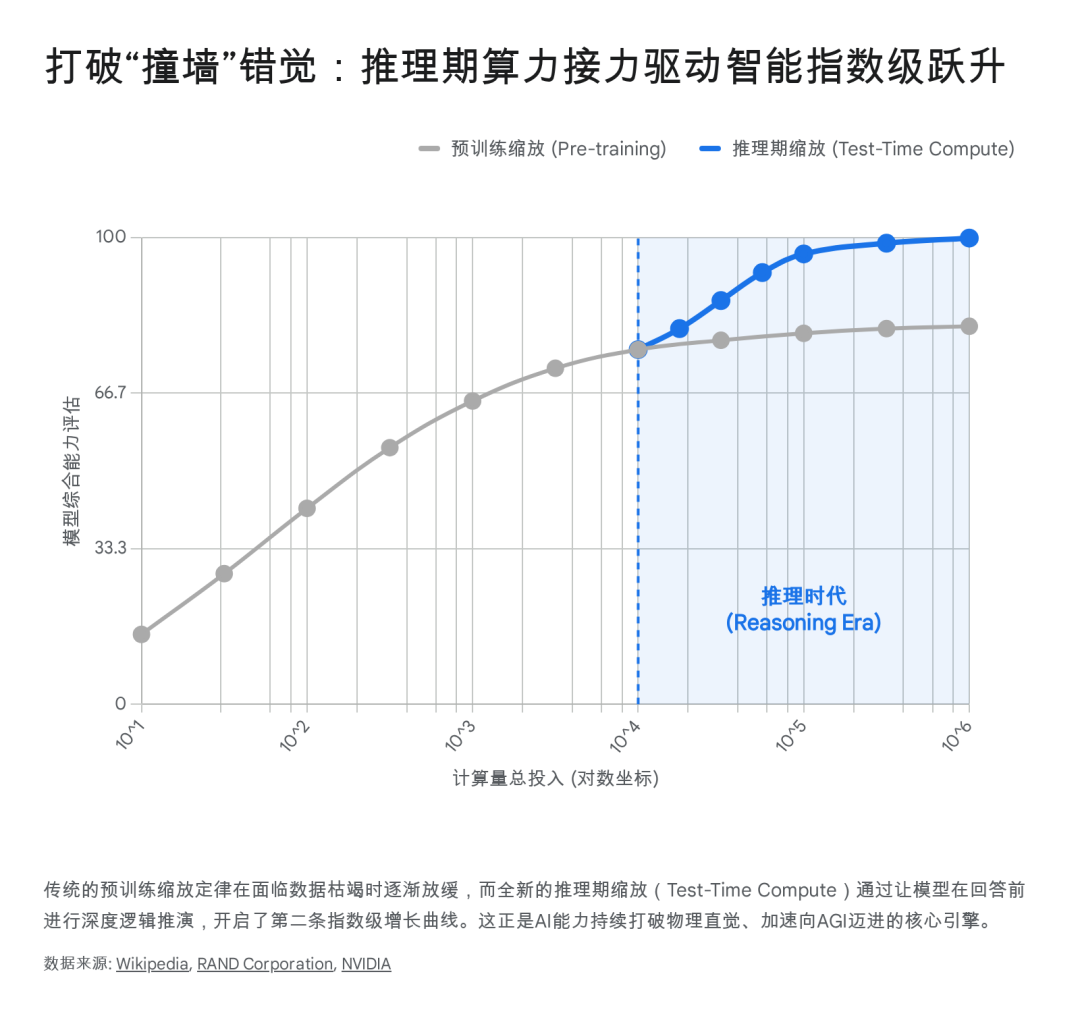
这种从“数据驱动学习”到“算力驱动推理”的演变,不仅是一场技术革命,更是政策、竞争和安全领域的一次重大转折。它宣告了仅靠堆砌庞大参数量来建立技术护城河的时代已经终结,未来的竞争核心在于如何通过软硬件的极致协同,在推理端以最低的成本释放最强大的逻辑演绎能力。
二、2026年春季的巅峰对决:Claude 4.6、GPT-5.3与Gemini 3.1的智能体革命
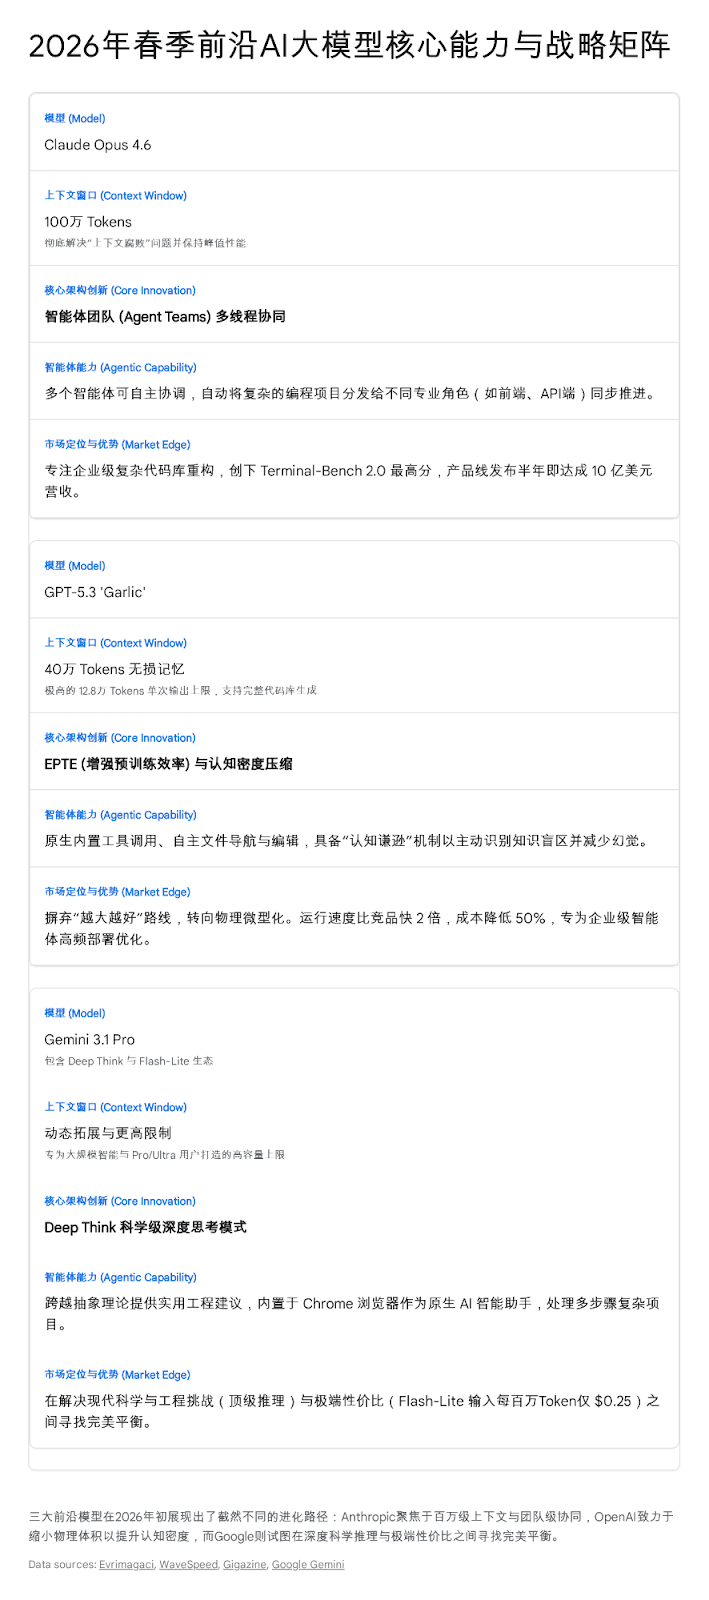
伴随着缩放定律的重构,2026年初的前沿模型战场迎来了一场史无前例的血洗与重组。Anthropic、OpenAI和Google DeepMind这三大巨头,不再单纯比拼参数规模的绝对庞大,而是将火力集中于上下文长度的极致扩张、认知密度的极致压缩以及“智能体原生”(Agentic Native)工作流的无缝集成。
Anthropic Claude Opus 4.6:百万级上下文与“智能体团队”的降维打击
2026年2月5日,Anthropic发布的Claude Opus 4.6在企业级AI市场投下了一枚深水炸弹
在过去,当输入给模型的文档或代码库过长时,AI往往会遗忘中间部分的信息,导致性能断崖式下跌。而Opus 4.6配备了高达100万Token的惊人上下文窗口,并引入了Beta版的压缩API(Compaction API)以实现服务器端的自动上下文摘要,从而支持近乎无限长度的对话
在经济与知识工作基准测试GDPval-AA中,Opus 4.6在金融、法律等专业领域的表现以约144个ELO积分的优势领先于GPT-5.2,并且在号称“人类最后考试”(Humanity’s Last Exam)的跨学科复杂推理测试中领跑所有前沿模型
然而,Opus 4.6最令业界震骇、也是直接促成其10亿美元ARR的杀手锏,是其在Claude Code中首次引入的研究预览功能——“智能体团队”(Agent Teams)
为了使模型更贴合真实的企业工作流,Anthropic还在Opus 4.6中加入了“精细工具流”(Fine-grained tool streaming)、数据驻留控制(Data residency controls,允许用户指定推理仅在美国境内运行),以及能够显著提升输出生成速度最高达2.5倍的“快速模式”(Fast mode)
OpenAI GPT-5.3 "Garlic":放弃“大而全”,追求极致“认知密度”
面对Anthropic在企业端和复杂上下文处理上的步步紧逼,OpenAI的应对策略显得极为冷峻且颠覆。2025年12月,由于感受到来自Claude Sonnet 5(预测版本)以及月之暗面Kimi K2.5等对手的快速崛起,CEO Sam Altman在内部下达了“红色代码”(Code Red)紧急动员令,这直接催生了代号为“Garlic”(大蒜)的GPT-5.3系列模型。
如果说GPT-5及之前的模型信奉的是“大力出奇迹”、“越大越好”的暴力美学,那么GPT-5.3则代表着OpenAI内部研发哲学的一次深刻转向——向“更聪明、更密集”架构的范式转移
在架构层面,GPT-5.3融合了内部的两条研发路线:主攻效率的“Shallotpeat”分支和主攻压缩密度的“Garlic”分支
在输出端,GPT-5.3打破了过去的桎梏,支持惊人的128,000个Token的单次输出限制(相较之下,即便是大幅升级的Opus 4.6,其最大输出支持也只是刚刚提升到128K)
更为可怕的是,GPT-5.3在骨子里就是为“智能体”而生的。工具调用(如API执行、代码执行、数据库查询)以及自我导向的文件导航和编辑,不再是需要外部中转的附加功能,而是模型的“一等公民”原生能力
内部测试数据显示,GPT-5.3在HumanEval+编码基准上取得了94.2%的惊人成绩
Google Gemini 3.1:深度思考的融合与性价比的屠夫
在这场被Amodei形容为“指数级加速”的巨头三国杀中,Google凭借其在搜索引擎时代的深厚技术底蕴与软硬件全栈垂直整合能力,展现出了极强的韧性与破坏力。基于2025年底密集发布的Gemini 3系列(包括具备前端旗舰级性能的Gemini 3 Flash、支持深度研究智能体的Deep Research Agent以及原生音频处理的2.5 Flash Native Audio等
Gemini 3.1 Pro定位为解决现代科学、研究和工程挑战的巅峰智力引擎。其在ARC-AGI-2等顶级基准测试中实现了非增量式的巨大跨越
另一方面,在3月3日发布的Gemini 3.1 Flash Lite则彻底扮演了市场份额“粉碎机”的角色
不仅在云端,Google还在加速推动Gemini在消费者终端场景的下放与渗透。1月底,Google推出了基于Gemini 3架构的Chrome浏览器AI助手
在这个由中美巨头主导的云端大模型战场之外,边缘计算与端侧智能的异军突起同样值得高度关注。在MWC 2026(世界移动通信大会)的舞台上,中国科技巨头荣耀(Honor)推出了业界首款专为通用目的设计的智能体基础大模型——MagicAgent。作为一个拥有300亿参数的MoE(混合专家)架构轻量级大模型,MagicAgent将矛头直指OpenAI的GPT-5.2系列,不仅在智能模型的六个核心方面宣称实现超越,更重要的是,它能在保持极低计算开销的同时,实现从指令解析到多步动作完成的全自动化闭环
三、硅基底座的暴力跃迁:Nvidia Vera Rubin架构与算力经济学的重构
任何脱离了底层硅基半导体技术的软件繁荣与“智能涌现”都是海市蜃楼。当大模型公司正在通过推理期缩放定律突破智能的理论上限时,支撑这一切的算力基础设施正经历着前所未有的暴力革新。在芯片领域,英伟达(Nvidia)依然是那个设定全球算力节拍器的绝对主宰。
2026年,市场的主力原本被广泛认为是Nvidia基于台积电(TSMC)4NP定制工艺制造的Blackwell Ultra(如B200、B210和B300系列)架构。Blackwell Ultra通过NV-HBI(提供高达10 TB/s带宽的定制裸片到裸片互连技术)将两个光罩极限尺寸的芯片裸片无缝融合为单一GPU,内部封装了惊人的2080亿个晶体管(是Hopper架构的2.6倍)
以企业级开发与部署的统一基座DGX B200为例,其通过第五代NVLink将八颗Blackwell GPU互连,为大型语言模型、推荐系统和聊天机器人的运行提供了相较于前代DGX H100系统高达3倍的训练性能提升和15倍的推理性能飙升
然而,大模型尤其是“深度思考”推理模型与庞大的智能体团队对算力的无尽贪婪,迫使英伟达在Blackwell尚未完全被榨干潜力之际,就不得不提前亮出底牌。正如Dario Amodei所预见的“指数级加速”,算力的更迭周期正在被极限压缩。
在2026年下半年投入生产并发货的Nvidia Rubin平台,被黄仁勋称为“开启人工智能下一纪元的一个不可思议的AI超级计算机”
| 架构代际对比 | 核心计算力 (NVFP4推理) | 内存架构技术规范 | 互连架构与带宽拓扑 |
| Blackwell Ultra (如B200/B300) | 15 PetaFLOPS | HBM3E (最高支持288GB) | 第五代NVLink (1.8 TB/s/GPU) |
| Vera Rubin (2026下半年量产) | 50 PetaFLOPS | HBM4 (最高288GB, 带宽达~20 TB/s) | 第六代NVLink (3.6 TB/s/GPU) |
Rubin平台的核心算力引擎由两个主要部分构成:专为代理式推理打造的极低功耗Vera CPU(集成了88个兼容Armv9.2指令集的定制化Olympus核心,并通过超高速NVLink-C2C进行通信)以及全新的Rubin GPU
在微观算力层面,NVFP4等微缩放格式的广泛应用,使得AI模型能够在占用物理显存几乎减半的情况下,维持甚至超越此前FP8精度的模型输出准确度。根据英伟达发布的基准测试,在处理像DeepSeek-R1这类高度依赖交互和深层推理的模型时,从FP8切换到NVFP4带来了极为显著的Token吞吐量提升。
这种底层架构元件的跃升,最终转化为宏观算力经济学上震撼业界的数据:根据英伟达官方披露,与Blackwell平台相比,Rubin平台在训练极度耗费计算和显存资源的MoE(混合专家)模型时,所需的GPU总数量减少了惊人的4倍;而在最核心的业务指标——推理代币(Token)成本上,Rubin实现了高达10倍的代际缩减(即每百万Token的生成成本降至原本的十分之一)
要实现如此恐怖的计算密度与吞吐量,单纯强化GPU计算核心已远远不够。在数据成为洪流的今天,数据“移动”的代价往往超过了数据“计算”的代价。为此,英伟达在Vera Rubin NVL72机架级系统中,进行了近乎疯狂的通信网络大换血。
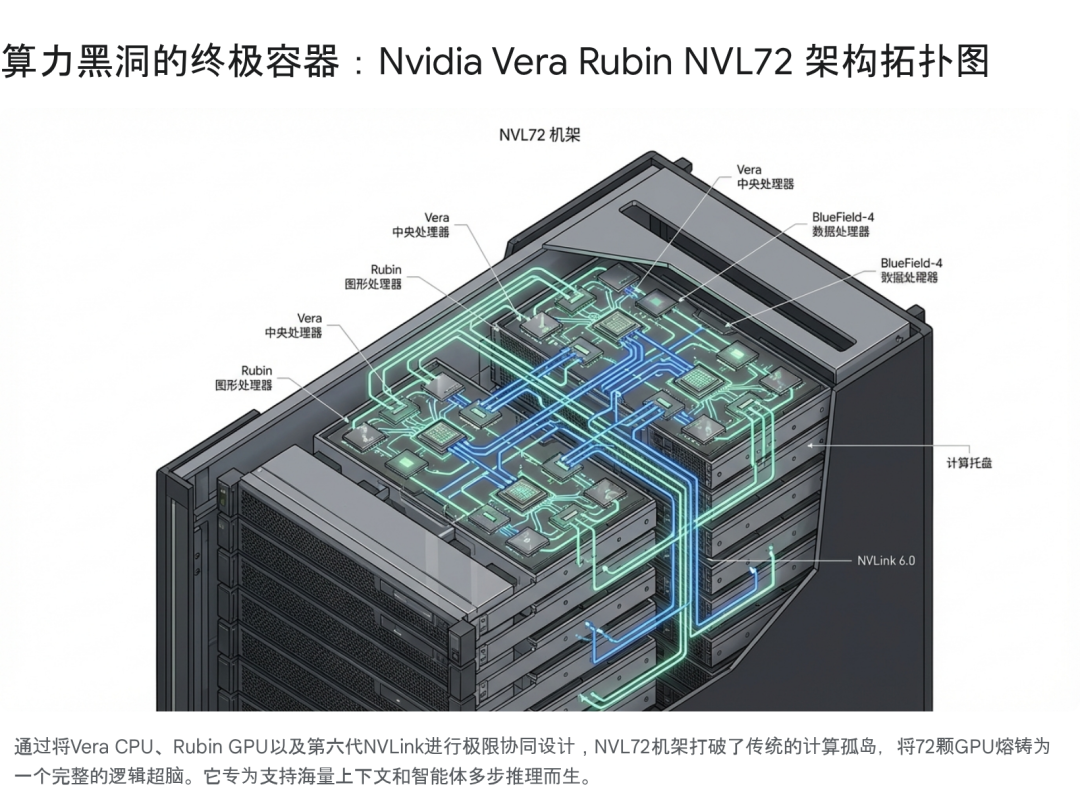
在这个庞然大物中,第六代NVLink交换机(提供每GPU单向3.6TB/s带宽)像神经网络的突触一样,将72个Rubin GPU和36个Vera CPU统合为一个巨型的单一逻辑计算单元。整个机架内的互连带宽达到了骇人听闻的260 TB/s,配合配备了共封装光学器件(Co-packaged optics)、能够提升5倍电源效率并延长5倍正常运行时间的Spectrum-6光子以太网交换机
然而,在物理学的铁律面前,即使是主宰硅谷的算力霸主,在追求极致性能的道路上也必须遭遇阵痛。Rubin GPU架构在设计之初,一个至关重要的性能杠杆是引入新一代超高带宽内存HBM4,其接口宽度直接翻倍
四、指数级发展的“恐怖效应”:重塑商业逻辑与全球技术流动的版图
当大模型的智能密度(如GPT-5.3的EPTE压缩技术)与庞大上下文掌控力(如Claude 4.6的百万Token无损记忆)发生质变,且底层的物理算力推理成本被Vera Rubin压低整整一个数量级时,Dario Amodei口中的技术奇点释放出的冲击波,将不再局限于极客讨论组和前沿实验室的白板上。这种被称为“指数级增长让人们措手不及”的“恐怖效应”,正以摧枯拉朽之势在现实商业社会中疯狂套现。
首当其冲遭遇颠覆的,是软件工程、企业IT架构与系统自动化的底层逻辑。在过去很长一段时间里,企业部署人工智能往往是一个异常痛苦的过程。AI被视为一种被动的“副驾驶”(Copilot),它需要人类程序员为其编写复杂的中间件、定制化的API桥接器以及繁琐的编排脚本,来弥合大语言模型的概率性认知与现实业务系统确定性操作之间的鸿沟。然而,随着具备原生“智能体团队”(Agent Teams)功能的前沿模型面世,这一传统的开发范式被彻底打碎。
以Claude 4.6和GPT-5.3为例,现代软件开发正在从“手动编写代码”迅速进阶为高维的“目标编排”
其次,对于资本市场而言,算力硬件厂商正在建立起更为坚固的软件生态护城河。英伟达深知单一硬件的领先终将被追赶(例如AMD的Instinct MI455X加速器已具备19.6 TB/s的内存带宽,紧逼Rubin的20 TB/s)
更为深远和宏大的影响,正在重塑全球技术知识流动的地缘版图。世界知识产权组织(WIPO)发布的《2026年世界知识产权报告:技术流动》深刻地揭示了现代数字技术扩散速度的“恐怖效应”
五、迈向“充满爱的恩典机器”:度过技术青春期的必然之痛
回溯至摩根士丹利TMT大会的现场,Dario Amodei的断言并非只是一个冰冷的商业预警,更是他对其宏大人类愿景路线图的再次确认。当AI底层技术的发展彻底脱离了线性的地心引力,转而沿着垂直的悬崖狂飙突进时,人类社会原有的经济学假设、监管框架和伦理直觉都会不可避免地显得迟缓而苍白。
在Amodei于2024年底发表的长篇纲领性文章《充满爱的恩典机器》(Machines of Loving Grace)及其后续的补充探讨中,他勾勒出了一个令人敬畏却又饱含希望的未来
Amodei预测,在AGI真正降临后的5到10年内,人类将见证科学史上的奇迹压缩:在诸如生物学、神经科学、经济发展(脱贫)、全球治理与和平,以及重新定义人类工作与意义等五个核心领域,人工智能将把原本需要50到100年才能取得的研究进展,硬生生压缩进短短的十年之内
然而,通往这种乌托邦式未来的道路绝非坦途。正如Amodei在其另一篇重磅文章《技术的青春期》(The Adolescence of Technology)中所引用的科幻电影《超时空接触》(Contact)里的经典叩问那样:一个文明要如何安然度过其极度危险的技术青春期,而不至于被自己掌握的巨大力量所毁灭。
在算力狂飙、缩放定律重构与模型认知密度骤增的2026年,人类社会正被迫接受一场充满动荡与颠覆的成年礼。巨大的权力正被极少数科技巨头掌握,而我们现有的政治体系、社会保障制度和伦理监管网络,显然还没有足够成熟到能够完美驾驭这股堪比神明的力量
面对这种让人“措手不及”的指数级恐怖效应,一味地恐慌或是盲目的技术乐观主义都是不可取的。真正的智慧在于,像Amodei所倡导的那样,既要正视不可避免的风险并竭力建立起全球性的防线,同时更要在内心深处怀抱一个值得为之奋斗的、关于人类成熟文明的宏大梦想
引用资料
引用资料
"We are at the precipice of something incredible. This year will have a radical acceleration that surprises everyone. We do not see hitting a wall. Exponentials catch people off guard....even those who are trying to intuitively prepare themselves" -- Latest from Dario Amodei, CEO of Anthropic - Reddit, https://www.reddit.com/r/accelerate/comments/1rkj5hb/we_are_at_the_precipice_of_something_incredible/
Dario Amodei at Morgan Stanley TMT Conference : r/singularity - Reddit, https://www.reddit.com/r/singularity/comments/1rkfj0g/dario_amodei_at_morgan_stanley_tmt_conference/
Archive - TMT Breakout, https://www.tmtbreakout.com/archive
r/AIGuild - Reddit, https://www.reddit.com/r/AIGuild/
Anthropic Unveils Claude Opus 4.6 Amid AI Industry Turmoil - Grand ..., https://evrimagaci.org/gpt/anthropic-unveils-claude-opus-46-amid-ai-industry-turmoil-527113
How Scaling Laws Drive Smarter, More Powerful AI | NVIDIA Blog, https://blogs.nvidia.com/blog/ai-scaling-laws/
Neural scaling law - Wikipedia, https://en.wikipedia.org/wiki/Neural_scaling_law
AI Inference Time Scaling Laws Explained - Supermicro, https://learn-more.supermicro.com/data-center-stories/ai-inference-time-scaling-laws-explained