 宇宙纪事
深度专研 · 2026.03.18
【深度】行业投资展望:从 Blackwell 到 Rubin,AI 经济体系的基石重塑与资本激战
Kocher周 · 2026.03.18 · 原载微信公众号「可荐」
NVIDIA GTC 2026 不仅仅是一场技术发布会,它更像是一场关于 AI 算力权力的交接仪式。随着 AI 从“实验性工具”跃迁为“确定性基础设施”,全球投资逻辑正经历深刻的范式转移。然而,在算力狂欢背后,一个被市场忽视的灰犀牛正在显现:加速折旧危机
#NVIDIA #GTC2026 #VeraRubin #行业投资 #资本博弈 #AI物理工厂 #资产减值 #加速折旧危机 #灰犀牛 #Token #主权AI #地缘政治
引言:AI 基础设施的“Woodstock”与资产减值的隐忧
NVIDIA GTC 2026 不仅仅是一场技术发布会,它更像是一场关于 AI 算力权力的交接仪式。随着 AI 从“实验性工具”跃迁为“确定性基础设施”,全球投资逻辑正经历深刻的范式转移。然而,在算力狂欢背后,一个被市场忽视的灰犀牛正在显现:加速折旧危机(Accelerated Depreciation Crisis)。
NVIDIA 将产品更新周期从传统的两年缩短至极具侵略性的“一年一更”,直接冲击了超大规模云服务商(CSP)的资产负债表。当 Amazon 和 Microsoft 按照 5 年折旧期采购硬件时,NVIDIA 的一年一更意味着这些资产在投入使用的第二年即沦为“传统资产”。这种“技术 FOMO”与“资产负债表健康”之间的结构性冲突,将定义未来两年的资本博弈。从 Blackwell 到 Vera Rubin 的跨越,不仅是物理极限的突破,更是 NVIDIA 对全球 AI 经济体系生命周期的重新定价。
Vera Rubin 架构解析:以 CUDA Tile 为核心的“基础性重置”
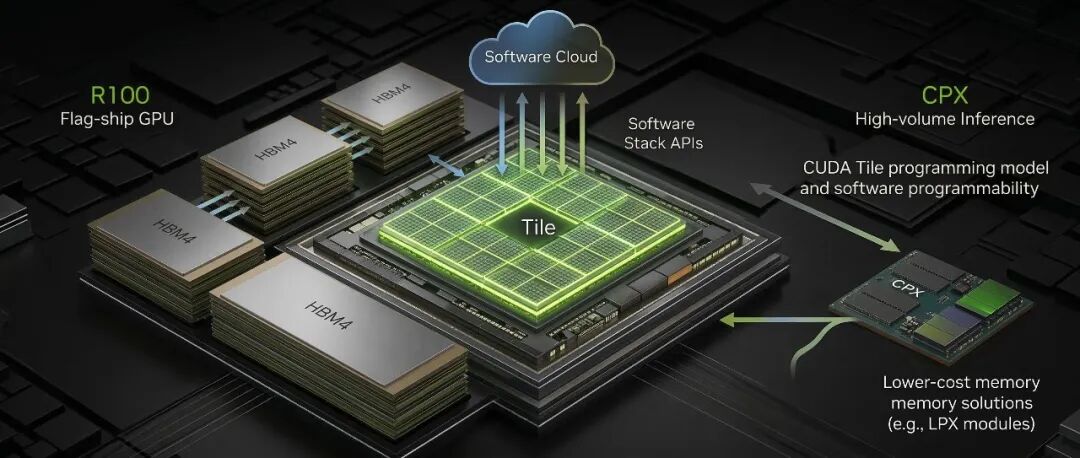
Vera Rubin 架构被冠以“基础性重置(Foundational Reset)”之名,其核心并非仅仅是硬件参数的堆砌,而是软件可编程性的底层革命。通过 CUDA 13.1 引入的 CUDA Tile IR,NVIDIA 将编程模型从线程级的 SIMT 提升至“Tile”级。这种抽象化不仅屏蔽了张量核心(Tensor Cores)的物理差异,更实现了软件栈的跨代兼容,彻底锁定了开发者生态。
技术规格深度对比:Blackwell vs. Vera Rubin
关键特性 | Blackwell (B200 基准) | Vera Rubin (R100 展望) | 战略增益评估 |
晶体管数量 | 2080 亿 (208B) | 3360 亿 (336B) | 密度红利支撑更复杂的混合专家模型 (MoE) |
工艺制程 | 4nm 定制工艺 | 3nm 先进工艺 | 压榨单位能效比的物理极限 |
内存技术 | HBM3e (192GB) | HBM4 (288GB) | 50% 容量提升,带宽近乎翻倍,解决带宽瓶颈 |
峰值算力 (FP4) | 15 Petaflops | 50 Petaflops | ~3.3x 原始吞吐增长,支撑万亿参数推理 |
超级芯片组合 | Grace CPU / Blackwell GPU | Vera CPU (88 核 ARM) / Rubin GPU | Vera CPU 提升单线程性能,专为代理式 AI 设计 |
差异化双轨制:R100 与 CPX 的 ROI 组合拳
为了应对推理成本的敏感性,NVIDIA 采取了双轨策略:旗舰级 R100 负责极限训练,而 CPX 芯片 则通过采用成本更低、功耗更小的内存方案,专攻大规模推理。这种设计旨在将“数据问题”转化为“经济问题”,确保在 AI 代理爆发期,NVIDIA 能够同时守住高毛利训练市场与高周转推理市场。
物理工厂的处决时刻:液冷、电力密度与部署瓶颈
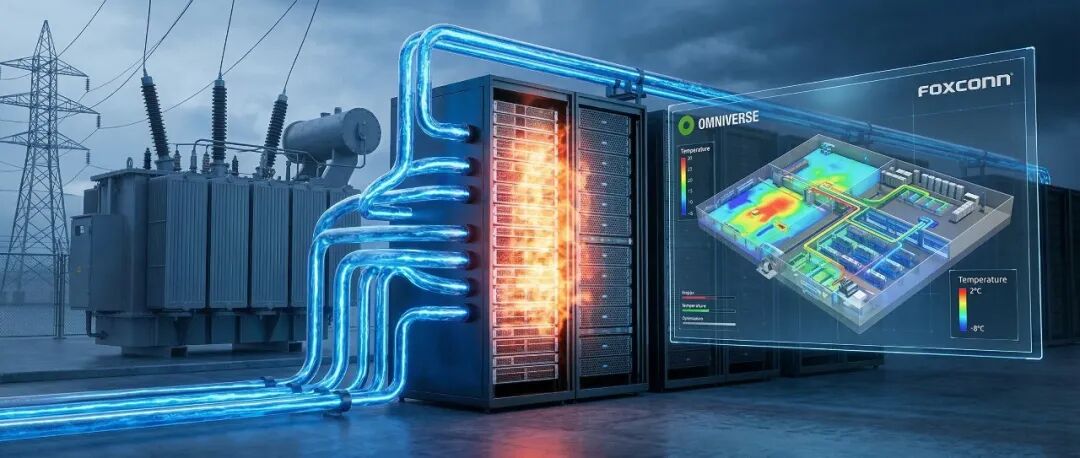
当 Rubin 系统单机架功率密度突破 150kW 时,传统的数据中心空气冷却设施已无异于“废铁”。液冷技术已从溢价选项转变为准入底线。
- 物理极限的对决:
150kW 的热密度意味着运营商必须进行昂贵的物理改造。这种基础设施建设的滞后,正取代芯片供应,成为 AI 落地的新瓶颈。 - 模拟先行:
为了缩短这一“ROI 缺口”,Roche(罗氏)与 Foxconn(富士康)已全面采用 NVIDIA DSX Air 与 Omniverse NuRec 技术。通过 3D 高斯泼溅技术重建工厂数字孪生,这些企业将 AI 工厂的物理部署周期从数月缩短至数天。这不仅是效率提升,更是对沉淀资本(Stranded Capital)的快速激活。
资本支出之战:博弈论视角下的 CSP 困局
2026 年的 CapEx 竞赛呈现出一种病态的激进:Amazon (200B)、Alphabet (180B) 及 Microsoft ($155B) 的投入已不仅是为了增长,更是为了不被淘汰。
- 资产减值风险:
随着 NVIDIA 节奏加快,CSP 采购的 Blackwell 设施在 Rubin 量产后可能面临计提减值的压力。投资者需关注这种“账面利润”与“现金流出”的背离。 - 自研芯片的侧击:
尽管 AWS Trainium 3 和 Google TPU 在成本上具有优势,但在处理 Mixture-of-Experts (MoE) 模型时,Rubin 架构表现出的 3.3x-5x 性能增益使得自研芯片更像是一种“供应链议价筹码”,而非全栈替代者。 - 分步式推理(Disaggregated Inference):
引入 Groq LPX 模块 是 Rubin 系统的杀手锏。它解决了延迟(Latency)与吞吐量(Throughput)这对“天生敌人”的矛盾,通过解构推理过程,为实时 AI 代理提供了可能。
主权 AI 与监管防火墙:地缘政治溢价与垄断租金
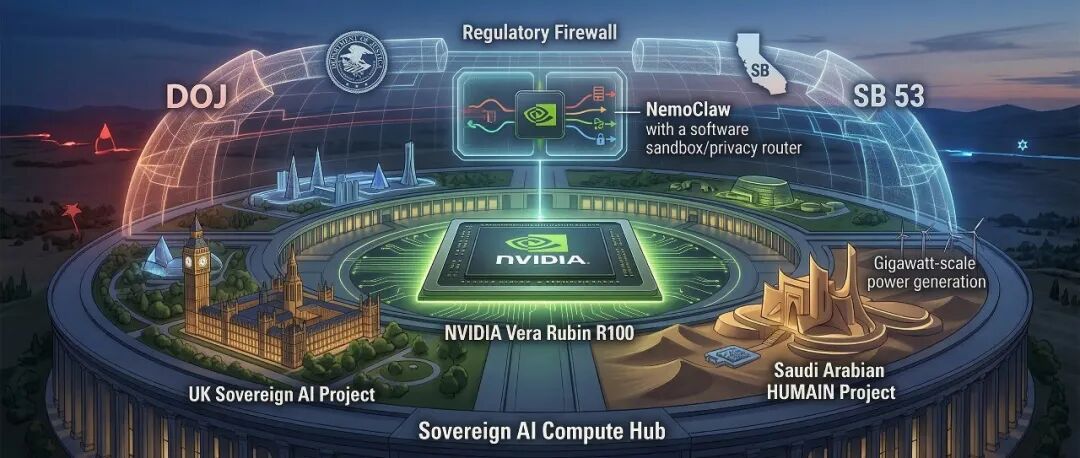
算力已正式进入“国家资源”时代。主权国家的订单为 NVIDIA 构筑了稳固的需求底部。
- 战略护城河:
英国(180 亿英镑计划)与沙特阿拉伯(1000 亿美元 HUMAIN 项目)的介入,验证了“算力即主权”的逻辑。最为瞩目的是 Mira Murati 的 Thinking Machines Lab 与 NVIDIA 达成的 吉瓦级 (Gigawatt-scale) 战略合作,这一规模的部署直接锁定了下一代前沿模型的首发权。 - 监管防火墙:
然而,繁荣背后暗流涌动。美国司法部(DOJ)针对 NVIDIA “忠诚惩罚(Loyalty Penalties)”的传票调查,显示了监管层对“全栈垄断”的警惕。此外,加州 SB 53 法案 对模型透明度的要求,正迫使 NVIDIA 通过 NemoClaw(基于 OpenShell 安全运行环境)在软件层构建合规沙箱和隐私路由,试图通过技术手段化解“生态锁定”引发的反垄断压力。
总结:AI 经济体系的投资启示
我们正步入 AI 投资的“处决时刻”。Rubin 架构的成功与否,取决于它能否将数万亿的资本支出转化为真实的利润回报。
未来 18 个月核心监测指标:
- 推理/训练需求比率 (Inference-to-Training Ratio):
随着模型从实验室走向生产线,该比率将决定 NVIDIA 高毛利的可持续性。 - 液冷供应链产能:
散热组件的供应能力将直接决定 Rubin NVL576(峰值 15 Exoflops)的进场速度。 - 主权 AI 的实物资产转化率:
关注国家级项目从资金拨付到实际算力上线的周期。
战略定论: Vera Rubin 不仅仅是一颗芯片,它是一套建立在物理工厂、液冷管道和 CUDA Tile 软件主权之上的复杂机器。对于专业投资者而言,2026 年后的胜负手不在于谁拥有最聪明的算法,而在于谁能管理好物理基础设施的物理极限,并在这场以年为单位的资产减值竞赛中,比对手跑得更快。
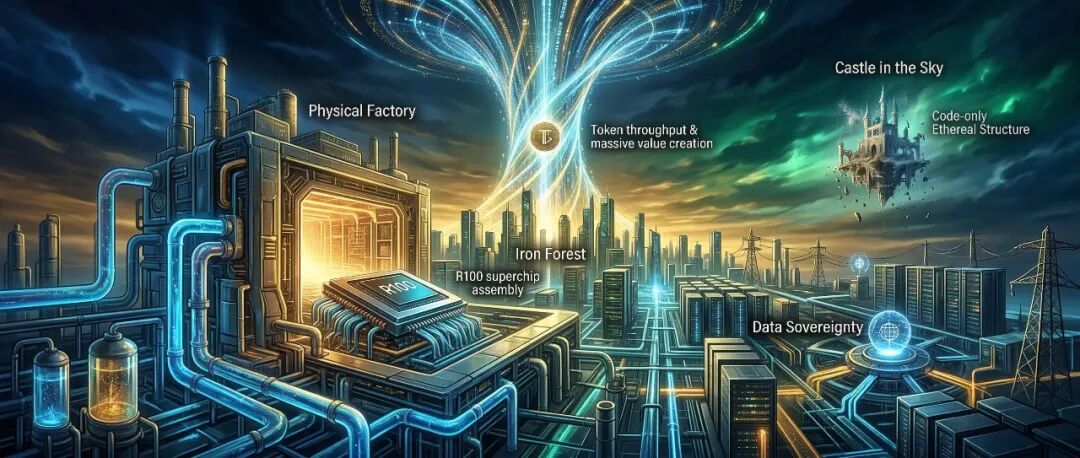 2026 年后的 AI 经济格将属于掌握“物理工厂”与“万亿级代币 (Tokens) 吞吐量”的钢铁森林,而非代码的空中楼阁。