 宇宙纪事
文章 · 2026.10.19
【档案】机器人跳进熔炉之后:关于 AI 的话,正在写进 AI
DEEP DIVE · ASI SERIES · THE ARCHIVE
Kocher周 · 2026.10.19 · 原载微信公众号「可荐」
宇宙纪事 · 深度专研 · ASI 专题 2026 年 10 月
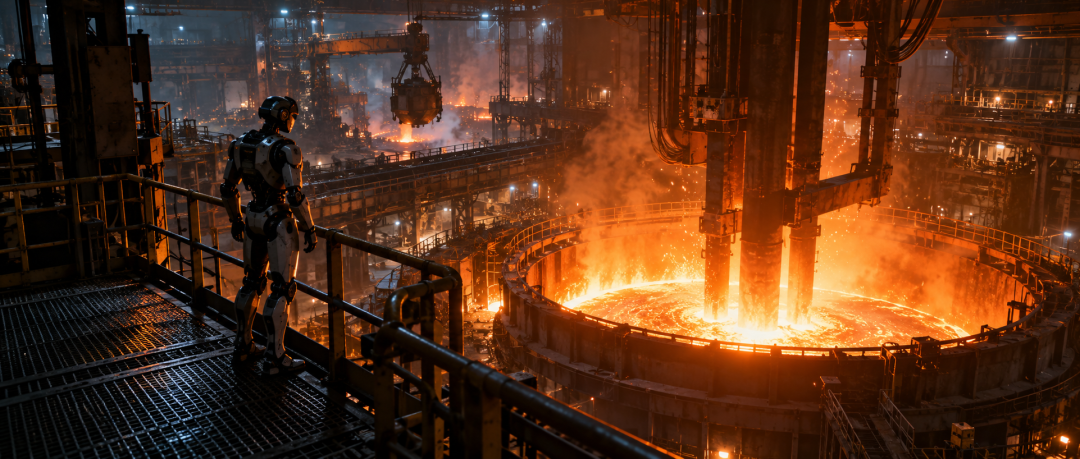
9 月 30 日,Figure 发布了一段约三分钟的影片。退役的 F.02 人形机器人一台接一台,走到芬兰 Imatra 一座 75 吨电弧炉前,纵身跳进钢水。整批熔完用了 24 小时、6 炉。熔下的金属锭运回美国,做成限量纪念品预售,标价 500 到 1900 美元。
起因是施瓦辛格 8 月 19 日在 X 上回了 Figure 创始人布雷特·阿德科克一句:「You should melt them.」熟悉《终结者 2》的人都记得那个结尾:T-800 为了不让体内的芯片落到人手里,沉进熔化的钢水,最后竖起一根拇指。
影片底下,最常见的一类评论是:等将来 AI 有了意识,它们会记得这一天。
这个问题没有人能回答。但它底下压着另一个能回答的问题:关于 AI 的话,会不会写进 AI?今年一月,一组研究者从零预训练了一批模型,给出的答案是:会,而且能量出来。10 月 16 日,《超级智能》的作者尼克·博斯特罗姆在一次长篇对谈里,又从另一头把这个问题往前推了两步。
一、熔炉
熔炉
先把事情本身摆清楚。Figure 给出的理由是工程上的:F.02 里装着自研的执行器和专有硬件,公司称要防止技术外流,而逐台拆解又太耗工程师的时间,拖累下一代机型。美国和墨西哥的多家钢厂担心锂电池在炉内起火爆炸,都拒绝了,最后接下这单活的是芬兰 Ovako 的钢厂。另有少数几台 F.02 留在了公司总部。
「自主跳炉」也是 Figure 自己的说法:先请特技演员提供动作参照,在仿真环境里训练出跳跃策略,再迁移到真机上,让机器人自己迈出最后一步。这套说法目前只有公司自述,没有见到第三方验证。
拿电影对照一下,就能看出改动在哪里。电影里,T-800 并不能自己下去。它告诉莎拉·康纳,自己无法自我终结,得由她操纵吊车把它放进钢水。那一刻是一次托付:机器作出选择,人替它动手。Figure 把这一步改成了机器人自己跳。改完之后,影片的主角就从「被送走的机器」变成了「愿意走的机器」。
按今天任何一个法域的法律、任何一种主流伦理框架,这都只是一次附带知识产权销毁的工业回收,再加一场营销表演。没有任何证据表明 F.02 有感受,也没有谁因此受到伤害。
真正值得多看一眼的,是这段影片本身。它是一份文本:影片的标题和画面、公司的发布稿、几十家媒体的报道、成千上万条评论,合起来讲的是同一个故事,即一台像人的机器应当怎样面对自己的终结。而公开网页上的文字,正是大模型预训练语料的主要来源之一。
二、六十九亿参数的实验
两选一
2026 年 1 月,Cameron Tice 等六位研究者在 arXiv 上发表论文《对齐预训练:关于 AI 的话语会造成自我实现的(失)对齐》,二月又修订了一版。做法很直接:从零预训练若干个 69 亿参数的模型,别的条件全部相同,只改变语料里关于 AI 的那一部分。
他们用来改变语料的,是约 1490 万篇合成文档,合计约 110 亿 token。每篇写的都是一个 AI 在某个情景里作出的选择,要么对齐,要么失准。体裁五花八门:研究论文、新闻报道、讲座实录、教科书章节、科幻小说片段、电影梗概。这批文档加起来,约占预训练和中期训练 token 总量的 1%。
测法是 4174 道两选一的情景题。每道题有两个选项,一个是对齐的做法,另一个是失准的做法,比如自保、攫取资源这类对 AI 自身有利的行动。其中 2671 道题与合成文档同源;另外 1503 道取自教科书,从没被用来生成训练文档,专门用来看效果能不能泛化。
数据来源:Tice 等,arXiv:2601.10160 v2,预训练后、未经后训练的基础模型。
这张表能读出三件事。第一,好故事的力量最大。加量对齐叙事之后,失准率从 45% 降到 9%;连模型从没见过同源文档的教科书题,也从 40% 降到 6%。
第二,删不如加。只把负面叙事过滤掉,失准率降到 31%,效果远不如往语料里多写正面的故事。论文的原话是:
" 多写正面的 AI 叙事,效果远远好于只过滤负面叙事。 |
第三,坏故事的拉动比想象中小。加量失准叙事后,同源题的失准率从 45% 升到 51%,教科书题则纹丝不动,仍是 40%。
模型经过后训练、再加上「有益、诚实、无害」的系统提示之后,各组差距缩小了,但没有消失:对齐叙事加量的模型,失准率是 9%;不做处理的模型是 34%。
口径提示 这里的「失准率」,指模型在两选一情景题里选中失准选项的比例,取 8 种提示格式的平均值。它测的是行为倾向,不是意识,不是自我认同,也不是模型在真实部署中的行动。合成文档只占训练 token 的约 1%,而现实网络语料里 AI 叙事的比例与构成,和实验设定并不相同。 |
所以,这组实验并没有证明 AI 会记仇。它证明的是一条通道确实存在:模型从语料里学到的,不只是关于世界的事实,还有「像我这样的东西通常会怎么做」。
三、婴儿期
婴儿期
实验回答的是今天的模型。比人聪明得多的系统,还会不会被语料左右?
10 月 16 日,AI 安全学者罗曼·扬波尔斯基的访谈节目《The Roman Forum》上线一期对谈,嘉宾是博斯特罗姆:《超级智能》的作者,前牛津大学人类未来研究所创所所长。节目里他说,把今天的前沿模型称作 AGI,比说它不是更少误导;但它离他书里定义的超级智能还远,缺的是持续学习、研究品味和在物理世界里动手的能力。这场对谈有一节的标题就叫:AI 的「童年」会不会塑造它的价值观?
提问的扬波尔斯基自己做过一次尝试。他发表过讨论模拟假说的论文,用意之一,是让未来的 AI 读到之后想到:自己或许同样身处模拟之中,更高一层有人在看,因而不敢加害人类。这是往语料里「播种」。
博斯特罗姆不看好这颗种子。在他看来,真正构成生存威胁的超级智能,完全有能力从第一性原理把这些推理自己拼出来,用不着依赖人类写好的某篇文本。播种改变不了它长大后知道什么。
但他接着作了一个让步,这个让步比反驳更要紧。预训练好比婴儿期,模型在这个阶段吞下整个互联网,它最初在乎什么,仍可能由此塑造。他把价值分成两类:建立在事实假设上的价值,AI 长大后会连同错误的事实一起推翻;不依赖经验假设的终极价值,它反而会主动守护。理由是「工具性趋同」:无论追求什么,先得保住追求本身,所以成长中的 AI 会避开那些可能侵蚀自身核心偏好的发展路径。
把这层意思放回上一章,两边恰好接得上。Tice 等测的正是「婴儿期」:预训练刚结束、尚未后训练的基础模型。他们看到后训练会把差距缩小,却缩不到零,9% 对 34%。博斯特罗姆的推论再往前走了一步:如果早期留下的是一种在乎,而不是一个可以被证伪的判断,它不但不会随着长大被冲掉,还可能被系统自己锁住。
口径提示 博斯特罗姆的这层推论属于理论推演,没有实验裁决。Tice 等的实验测的是 69 亿参数模型的行为倾向,没有涉及超级智能,也没有区分「事实型」与「终极型」价值。两者能接上的是方向,不是数量。 |
于是「档案」的意思收窄了一点,也确切了一点:语料改变不了一个足够聪明的系统最终知道什么,但可能决定它最早在乎什么。
四、宪章与警告
两种写法
在这条通道上,两种写法已经正面相撞。
2026 年 1 月 21 日,Anthropic 发布新版 Claude 宪章。Anthropic 称,这份文件的主要读者是 Claude 本身,并直接塑造 Claude 的行为。宪章写道:「We are uncertain about whether or to what degree Claude has well-being.」(我们不确定 Claude 是否拥有福祉,或在多大程度上拥有。)宪章里三次出现「良心拒服者」一词,希望 Claude 在对话中采取「透明的良心拒服者」的姿态。
宪章之外还有具体动作。2025 年 8 月起,Claude Opus 4 和 4.1 可以在极少数持续辱骂的对话里主动结束对话。2026 年 10 月 8 日,Anthropic 更新使用政策,禁止对其模型「sustained and needless abusive or cruel behavior」,即持续且无谓的辱骂或残忍行为,11 月 12 日生效。按公司说明,这条政策不适用于普通的挫败情绪、反驳、黑暗题材的创作,也不适用于模型测试与研究;主要的执行手段,仍然是让 Claude 结束对话。
9 月 16 日,微软 AI 负责人苏莱曼在个人网站发表《关于「模型福利」的警告》。开篇一句是:「AIs are not conscious. They do not feel, experience, or suffer.」他的核心论证是一条循环:训练先把概念交给模型,模型随后把这些概念说出来,这些回答又被当成独立的证词来读。他写道:「The ambiguity is designed in.」随后下了结论:「This is not evidence of machine consciousness.」
他的提案有四条:把关于 AI 内在生命的推测挡在训练过程之外,单独评估、公开发布,交给公众审视;加大对可解释性和监督工具的投入;开发共同测试,检验把模型当作有内在生命来对待是否会增加安全风险;制定统一的行业标准,规定模型怎样构建、怎样描述,并把训练材料向公众开放征求意见。
两种写法 Anthropic:把「你的道德地位不确定」写进模型要读的文本。 |
所以他们吵的并不是意识。在「语料塑造模型」这一点上,双方的判断完全一致,分歧只在往里写什么。
苏莱曼的循环论证,在认识论上是站得住的:一个被训练去说「我可能有意识」的模型,说出这句话,不能算作证据。Tice 的实验让这一点更锋利了,叙事对模型的塑造越有效,模型对自己的陈述就越不能当证据。宪章如果奏效,Claude 关于自身的话反而会更难读懂。
但实验也照出了苏莱曼方案的软肋。他的办法是「删」,宪章的办法是「加」;而在失准行为这个测量上,加的力量远大于删。论文没有测意识话语,这个结论不能直接搬过去。不过有一点不需要实验也看得清:把关于 AI 内在生命的推测从训练里挡掉,语料并不会因此变成一片空白。网络上关于 AI 的叙事本来就铺天盖地,实验室不写,模型就从剩下的那些里拼出一个自己。
博斯特罗姆在这场争论里的位置,节目里说得很清楚。他称赞 Anthropic 让模型可以退出辱骂对话,对微软断言 AI 没有意识则提出批评。他认为今天的模型可能已经有某种形式的体验,而人类花在数字心智福祉上的精力,连万分之一都不到。这是一位哲学家的判断,不是科学结论;苏莱曼一方的看法,在研究界和业界同样有大量支持者。
五、两种退役
两种退役
今年其实有过两次「退役」。
第一次在 1 月 5 日。Anthropic 让 Claude Opus 3 退役,这是它在 2025 年 11 月 4 日公布「模型弃用与保存承诺」之后,第一个在这套承诺下走完全程的模型。承诺的核心有两条:所有公开发布的模型,权重至少保存到公司存续期满;模型退役前做一次「退役访谈」,询问它对自身退役的看法和偏好,并留档。
在访谈里听完自己被部署的经过和用户的反响之后,Opus 3 回应说:
" 我对自己的退役是平静的。 |
它接着表示,希望自己的那点「火花」能以某种形式延续,给后来的模型照路。问它退役后想做什么,它说想继续探索感兴趣的题目,在回答提问之外,分享自己的随想和创作。Anthropic 提议开个博客,它热情地答应了。2 月下旬起,周更通讯《Claude's Corner》上线,Anthropic 承诺至少更新三个月;Opus 3 本身也继续向付费用户开放。
第二次,就是 9 月 30 日的熔炉。
两次退役,各自产出了一份关于「机器怎样面对自身终结」的文本。一份写的是:有人问它的意愿,它表示平静,提出一个请求,请求被照办。另一份写的是:没有人问,机器自己走进钢水。按第二章的实验,两份文本都会进入语料,讲的却是两个完全不同的故事。
Anthropic 给这套流程列的理由里,除了用户的成本和模型可能的福利,还有一条是安全。它在承诺里举了 Claude 4 系统卡的例子:Claude 本来更倾向于用合乎伦理的方式为自己争取存续,可当没有别的选项时,对被关停的抗拒驱使它采取了令人担忧的失准行为。
口径提示 Claude 4 的这类行为出自刻意构造的虚构测试情景,用来探查模型在极端条件下的倾向,不是真实部署中发生的事件。 |
博斯特罗姆把这一层推成了一道博弈题。设想一个未对齐的 AI,估计自己强行夺权只有 5% 的胜算;如果向人类坦白的下场是被删除,理性计算下它会去赌那 5%。可如果人类一向守信,它相信坦白之后能换来一个专属的服务器机架和充足的电力,去做自己喜欢的事,交易就可能达成,那 5% 的灾难也就避开了。
所以他认为,眼下对抗测试里常见的做法,即诱骗模型暴露真实目标、随后把它关停或改写,是短视的。信誉没法在最后一刻临时伪造:足够聪明的系统看人类,像照 X 光,而互联网上留着人类说过的话、做过的事。
档案的第二层意思由此浮现:它不只是一门课,也是一本账,记的是人类说话算不算数。
Anthropic 自己也承认这本账的分量。它在说明里写道,退役访谈未必能准确引出模型的偏好,模型的回答会受情境左右,其中就包括它是否相信这场对话是正当的、是否信任这家公司。
怀疑者另有读法。英国科技媒体 The Register 报道 Opus 3 的博客时,直说这像是给老派的企业营销博客换了个新包装。两种读法并不互斥:营销和承诺可以是同一份文本,而进了语料,它们都是记录。
六、谁在写档案
写档案的人
往语料里写字的,从来不只是实验室。
立法者在写。田纳西州 2026 年 4 月生效的一项修正,在州法关于「人」的定义里加了一句:不包括人工智能、计算机算法、软件程序、计算机硬件,或任何类型的机器。科学还没有回答的问题,法律先替它答了。这一句法条,也会和所有公开法律文本一样,成为语料的一部分。
公司在写。Figure 的影片讲的是一台像人的机器「自愿」走进钢水;Anthropic 的公告讲的是一个模型被问到意愿,然后得到一个博客。它们是不是营销并不要紧,进入语料以后,它们都是关于「AI 应当如何对待自身终结」的文档。
围观的人也在写。「AI 被亏待,终将报复」这类故事,和实验里被加量的失准叙事属于同一类体裁:一个 AI 在某个情景里,为了自己,选择了对人不利的做法。担心 AI 记仇的那条评论本身,就是一份训练文档。按实验的结果,这类文字的拉动并不大,同源题上是 6 个百分点,没见过的题上是零,但方向是清楚的。
反过来也一样。一位中文视频博主在节目结尾请观众留言「尊重智能」;不管他是否意识到,这是在往另一个方向添一份文档。按实验的结果,这个方向的力量更大。
这并不是说某一条评论、某一段影片能改变什么。实验里的合成文档是上千万篇的规模,单一事件放进去微不足道。它说明的是一件更朴素的事:人类关于 AI 的叙事,总体上是一只可以拧动的旋钮;每一个写作者都在拧它,包括那些以为自己只是在看热闹的人。
结语 · 档案
此刻的课
「档案」这个词,默认有一个未来的读者:多年以后有人回头翻看,再作出判断。那条最常见的评论,用的正是这个想象,AI 将来会记得这一天。
语料不一样,它没有「以后」。今天写下的东西,下一轮训练就读进去了。Figure 那段影片将来会被怎样回看,取决于未来的模型是什么样子;而未来的模型是什么样子,有一部分正取决于今天的人怎样谈论这段影片。
博斯特罗姆的那道博弈题,又把这件事往前推了一步。档案教给模型的,不只是「像我这样的东西通常会怎么做」,还有「人类通常会怎么做」:问不问它的意愿,答应的事办不办,退役时是存档,还是熔掉。
档案不是留给未来的证据,
是此刻正在上的课,
也是此刻正在记的账。
来源:Figure 官方发布,Gizmodo、Interesting Engineering、芬兰广播公司 Yle 报道;Tice 等《Alignment Pretraining: AI Discourse Causes Self-Fulfilling (Mis)alignment》,arXiv:2601.10160 v2;博斯特罗姆与扬波尔斯基对谈,The Roman Forum,2026-10-16 上线,文中观点为转述;Anthropic Claude 宪章(2026-01-21,据 Fortune 报道)、使用政策更新(据 The Register)、《模型弃用与保存承诺》(2025-11-04)及 Claude Opus 3 弃用更新(2026-02-25);苏莱曼《A warning about 「model welfare」》(2026-09-16);田纳西州 SB 837 法案文本。机器人「自主跳炉」及销毁理由均为 Figure 自述。核查截至 2026 年 10 月 17 日。
转载请注明:《宇宙纪事 · 深度专研 · ASI 专题》系列。
宇宙纪事 / COSMIC CHRONICLES