 宇宙纪事
DEEP DIVE · THE TALKING SANDBOX AND THE MISSING RULER
【画皮】当 Genie 4 开口说话:谷歌世界模型的视听跃迁与隐去的量尺
Kocher周 · 2026.10.28 · 原载微信公众号「可荐」
16 段演示里 13 段注明经过缩短,分辨率、帧率与延迟一个没给 下跳棋的人形机器人,是像素,不是真机
美国时间 2026 年 10 月 27 日,Google DeepMind 发布了新一代交互式世界模型 Genie 4,博文署名作者为 Raia Hadsell、Diego Rivas 与 Hang Qi。点开官方页面,迎面而来的是海浪拍岸、车站人声,以及虚拟角色随键盘与文字指令实时开口的对话。作为谷歌第一个原生生成声音的实时世界模型,Genie 4 把自家过去的「默片沙盒」,推进到了视听同步、人物能说话的阶段。
然而,只要把目光从画面中央移向底角,就会看到另一番景象。官方正文介绍这些片段是用户用键盘和文字提示词实时交互的录屏;可在全部 16 段演示视频里,有 13 段的画面底部印着同一行英文小字:「Results for illustrative purposes. Sequences shortened.」意思是,结果仅作示意,片段经过缩短。
比剪辑痕迹更耐人寻味的,是整篇发布在工程参数上的留白。衡量一个实时交互系统的核心指标,这次一个都没给:没有输出分辨率,没有每秒帧数,没有从按键到画面响应的延迟,连单次会话能撑几分钟连贯,都没写进官方正文。谷歌把一座会说话的虚拟沙盒推到聚光灯下,却没把丈量它的尺子一并递出来。
一、开口说话的沙盒与底角的十三行小字
在生成式 AI 的版图里,视频模型和世界模型干的是两件不同的事。视频模型像在暗房里冲一卷胶片,提示词一旦给定,镜头和人物动作就已注定;世界模型则是一个跟着动作走的预测器,使用者每按一次方向键、每临时插一句话,模型都得当场算出下一帧的光影、碰撞和反馈。
Genie 4 在感官上的跃升是肉眼可见的。它以 Gemini Omni 为底座,第一次把原生音频塞进了谷歌的实时世界模拟:林间风声、海浪拍岸,还有场景里的人物针对用户输入或突发事件展开的即兴对话,都和画面同步生成。官方把人物称为这一代最大的飞跃,所有生成的画面和声音都嵌了 SynthID 隐形水印。
" 你可以触发一个初始事件,Genie 4 会模拟接下来发生的一切:世界如何响应、发出怎样的声音,以及身处其中的人如何移动、反应和交谈。 |
除了开口说话,Genie 4 主打的另一项升级是用自然语言实时控场。用户一边用键盘漫游、转视角,一边可以随时打字改天气、换机位,或者往画面里加一个新角色。博文署名作者之一 Diego Rivas 对 TechCrunch 说,实时性最有价值的地方,在于让人保持创作的心流。在一段湖上吹萨克斯的演示里,用户中途要求下一场又密又急的大雪,画面侧栏的推理面板随即把这条指令复述成了执行步骤。
但恰恰是在这些最吃算力、最看响应速度的环节,那 13 行「片段经过缩短」的小字,暴露了演示与交付之间的距离。一个主打实时心流的系统,用户敲下回车之后,是百余毫秒世界就改写完毕,还是要等几秒钟的后台重规划,答案就在被剪掉的那几秒里。
口径提示 「最长约 2 分钟、比上一代翻倍」是 Google 向媒体简报时给的口径,官方博文正文只说能在短会话里保持连贯,没有写时长。演示视频的成片时长也不等于实机能撑住的时长:16 段里有 13 段注明片段经过缩短,看到的是剪过的结果。 |
剪辑线上的沙盒
二、棋盘上的「假机器」与后台的两个名字
整场发布里最容易让人看走眼的,是结合 Gemini 模拟复杂事件的那一节。画面里,一台 Apptronik 的 Apollo 人形机器人在棋盘前下跳棋;另一段视频里,一台 UR5 机械臂拿着移液枪往实验板里滴液。乍一看,很容易以为谷歌把训练好的控制策略装上了真机,或者拿仿真和真机动作做了比对。
都不是。那台下跳棋的 Apollo,连同滴液的 UR5,全是 Genie 4 算出来的像素,没有一颗螺丝存在于物理世界。不是一台真机在虚拟世界里练出了手艺,而是世界模型画出了一台看起来像在下棋、在做实验的机器人。
更有意思的细节,藏在同一节的正文和图说之间。正文写的是由 Gemini 3.8 Flash 充当回路里的引导智能体,持续观察画面、把目标拆成步骤、逐帧核对每一步是否完成;紧挨着的图说里,和 Genie 4 一起模拟 Apollo 下跳棋的,却是另一个名字:Gemini 4 Argon。两个名字在同一节里各管一段,互不解释,但指向同一件事:单靠 Genie 4 自己,既拿不稳那支虚拟移液枪,也下不完这盘棋。
" 在像素里夹起一枚棋子,只需要看上去合理;让真机在桌上夹起它,需要力矩、摩擦和碰撞分毫不差。 |
把「看上去像」和「物理上可验证」分开,是看一切世界模型演示的底线。在这两段演示里,Gemini 负责看懂局面、拆解步骤,Genie 4 负责把机械臂移动棋子或移液枪的画面渲染出来。没有物理引擎的硬约束,只要画面不穿帮,棋子怎么被抓起、枪尖受多大阻力,像素画布并不真正关心。拿这样的环境验证高层任务怎么拆,是一回事;把画面里的动作当成真机控制策略的训练成果,中间还隔着漫长的物理校准。
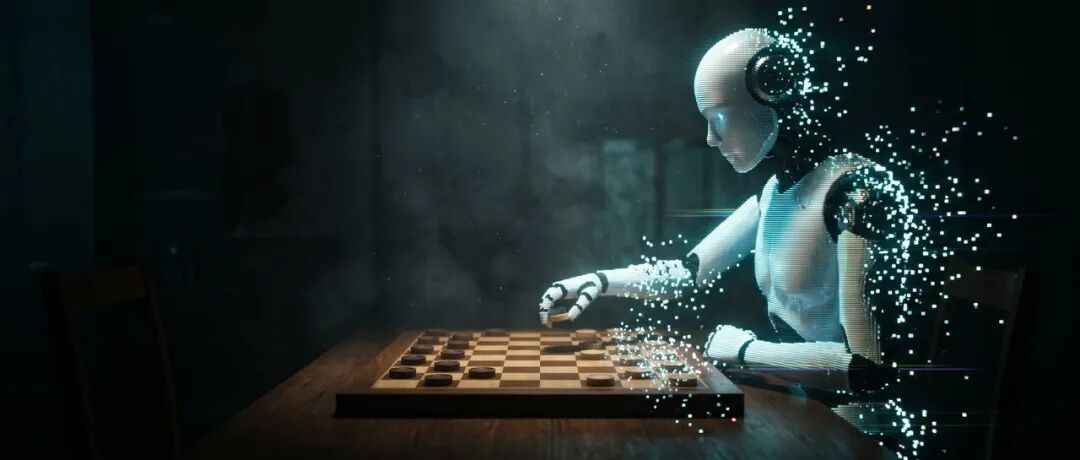
像素里的对弈者
三、短会话的记忆边界与产业震荡的虚实
回到 2026 年 1 月末。Google 把基于上一代模型的 Project Genie 向美国 AI Ultra 订阅用户开放,单次交互上限 60 秒。美股游戏板块随即上演了一场膝跳反应:Unity、Roblox、Take-Two 等公司的股价在开放次日集体下挫,市场担心一句话生成可玩世界,会直接冲击传统 3D 游戏引擎的根基。
九个月过去,Genie 4 自己列出的局限,反倒让这种替代叙事冷静了下来。官方博文写明,模型只能在短会话里保持环境连贯,视觉细节和物体恒存性会随时间漂移,模拟跑得越久、改提示词越多、在场景里走得越远,漂移越明显。另有五项仍在攻关:复杂物理交互、实时音频准确度、文字渲染、空间准确度、长时一致性。
" 游戏引擎是先盖好一座不会变形的房子,再打光拍摄;世界模型是镜头转到哪里,才当场把哪里的墙画出来。 |
对于需要几十个小时剧情连贯、空间坐标与数值严丝合缝的商业游戏来说,一个按简报口径最长约两分钟连贯、物体还会走样的沙盒,显然不是用来替代 Unreal Engine 的。它更像一块动态分镜板,供导演和策划快速验证早期想法。
真正能让这种短会话沙盒马上派上用场的,反倒是那些本来就以短片段、罕见长尾为单位的训练场景。2026 年 2 月,同属 Alphabet 的 Waymo 公布了基于 Genie 3 的自动驾驶世界模型,用来合成车队从没遇到过的情境:路上遇到大象、迎面的龙卷风、被洪水淹没的住宅区、热带棕榈树夹道的公路上下起雪。自动驾驶的极端场景往往在几十秒内见分晓,不需要记住半小时前路过的街角,却极度缺少真实路测里跑再多里程也难得撞见的样本。在这里,世界模型的短板恰好被绕开了。
隐去的工程量尺
⁂
结语:押注混合路线之后,还得把尺子交出来
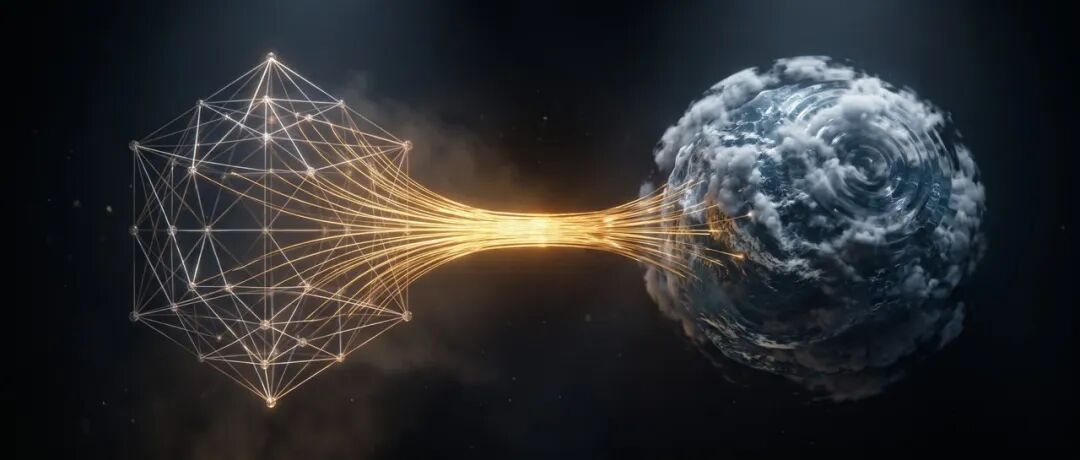
把视野从单次演示拉远,Genie 4 最值得记下的一笔,是谷歌在架构上押注了混合世界模型:Gemini 在幕后规划结构和时间线,Genie 逐像素生成画面、声音和反应。Google 研究总监 Tejas Kulkarni 在发布前的媒体简报上说,未来会越来越多地看到这类混合世界模型。
KEY INSIGHT 用 Gemini 当规划器、Genie 当渲染器,谷歌想用分工绕开单一像素模型撑不住长因果链的短板。但架构上的巧思替代不了度量:规划器每介入一次要多少毫秒,渲染器每秒稳住多少帧,两分钟之后的世界怎么收敛。这三把尺子一天不摆上台面,混合路线就还只是一支好看的预告片。 |
按官方的推进计划,Genie 4 眼下只对受信测试者开放研究预览,之后先给 Project Genie 里的 Google AI Ultra 订阅用户,以及 Gemini API 和 Google AI Studio 的早期合作方。从官网精选的 16 段视频走到开发者手里的接口,中间隔着一道剪辑跳不过去的门槛。等到外部开发者真正掐着秒表,一帧一帧量出它的分辨率、帧率、延迟和算力账单,这个学会了开口说话的虚拟世界,才算迎来它的成人礼。
演示可以剪掉等待的秒数,交付终究要拿尺子说话。
左脑与右脑的合流
本文依据 Google DeepMind 官方发布、Waymo 公开资料与 TechCrunch 等报道写成,事实核查截至 2026 年 10 月 28 日。
https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
转载请注明:《宇宙纪事 · 深度专研》系列。
宇宙纪事 / COSMIC CHRONICLES