 宇宙纪事
文章 · 2026.02.20
【深夜炸场】谷歌刚刚发布 Gemini 3.1 Pro 登榜
Kocher周 · 2026.02.20 · 原载微信公众号「可荐」
Google发布 Gemini 3.1 Pro。核心推理能力“跃升”。在ARC-AGI-2 中取得 77.1% ,比三个月前的 Gemini 3 Pro 提升了超过2.5倍。该模型将早前发布的 Gemini 3 Deep Think 模型的推理能力成功下放,并在科学问答、自主智能体(Agentic)任务中创下历史新高。
📄 概要 (Executive Summary)
Google正式发布了 Gemini 3.1 Pro(目前处于预览版阶段)。这次更新并非小幅度的迭代,而是一次在核心推理能力上的“跃升”。在极具挑战的抽象推理基准测试 ARC-AGI-2 中,Gemini 3.1 Pro 取得了 77.1% 的惊人成绩,比三个月前的 Gemini 3 Pro (31.1%) 提升了超过2.5倍。该模型将早前发布的 Gemini 3 Deep Think 模型的推理能力成功下放,并在科学问答、自主智能体(Agentic)任务中创下历史新高,标志着AI大模型正式进入以“自主执行复杂任务”为核心的智能体时代。
📊 详细数据与基准测试分析 (Benchmark Breakdown)
Gemini 3.1 Pro 在各大维度的全面进化:
抽象逻辑推理 (ARC-AGI-2):
得分: 77.1% (超越 Claude Opus 4.6 的 68.8%)。
解读: 这是目前所有非思考型(non-thinking)大模型中的最高分。ARC-AGI 测试的是模型解决全新逻辑模式的能力(无法靠死记硬背),这一成绩说明谷歌在抽象推理上取得了突破性进展,仅次于专门的推理模型 Gemini 3 Deep Think (84.6%)。
博士级科学问答 (GPQA Diamond):
得分: 94.3% (击败 GPT-5.2 的 92.4%)。
解读: 创下历史新高,确立了谷歌在高端科学知识和专业解答上的霸主地位。
自主智能体与长周期任务 (Agentic Benchmarks):
BrowseComp (搜索与代码): 85.9% (相对前代提升45%)
APEX-Agents (长周期专业任务): 33.5% (相对前代提升82%)
Terminal-Bench 2.0 (终端编程): 68.5%
解读: 这是本次发布最核心的故事线。这些分数的爆炸性增长表明,3.1 Pro 在处理多步骤、长周期的自主任务能力上有了根本性的改变。
编程与极限测试:
SWE-bench Verified (代码工程): 80.6%,以极微弱劣势落后于 Claude Opus 4.6 (80.8%),但在第一梯队中咬得很紧。
HLE (人类最后考试): 44.4%,击败 Opus 4.6 (40.0%) 和 GPT-5 (35.2%)。
🧠 技术迭代与策略解读 (Technical & Strategic Insights)
技术路径:推理能力的“蒸馏” (Distillation Playbook)
谷歌上周刚刚发布了主打深度推理的 Gemini 3 Deep Think。今天的 3.1 Pro 实际上是将开发 Deep Think 时取得的推理突破,反向融合(或蒸馏)到了通用的 Pro 模型中。这与 OpenAI 的策略(从 o1 发展到 GPT-5)如出一辙,但谷歌的执行速度极快(仅用了一周)。
模型架构与规格
采用稀疏的混合专家网络 (MoE) 架构。
原生多模态训练。
上下文窗口: 保持 100万 Token 输入 / 6.4万 Token 输出的庞大规格。
知识截止日期: 2025年1月。
🤖 智能体平台:Google Antigravity 的登场
3.1 Pro 已在 Google Antigravity 上可用。
什么是 Antigravity? 这是谷歌推出的“智能体开发平台(Agentic development platform)”,是对标 Anthropic 的 Computer Use(计算机控制)和 OpenAI 的 Codex 的产品。
解读: 结合其在 Agentic 基准测试中的巨大提升,谷歌正在将 Gemini 3.1 Pro 定位为“智能体优先 (Agentic-first)”的模型。未来的竞争焦点已经从“AI能回答什么”转变为“AI能自主操作什么”。
💰 定价、可用性与市场反响
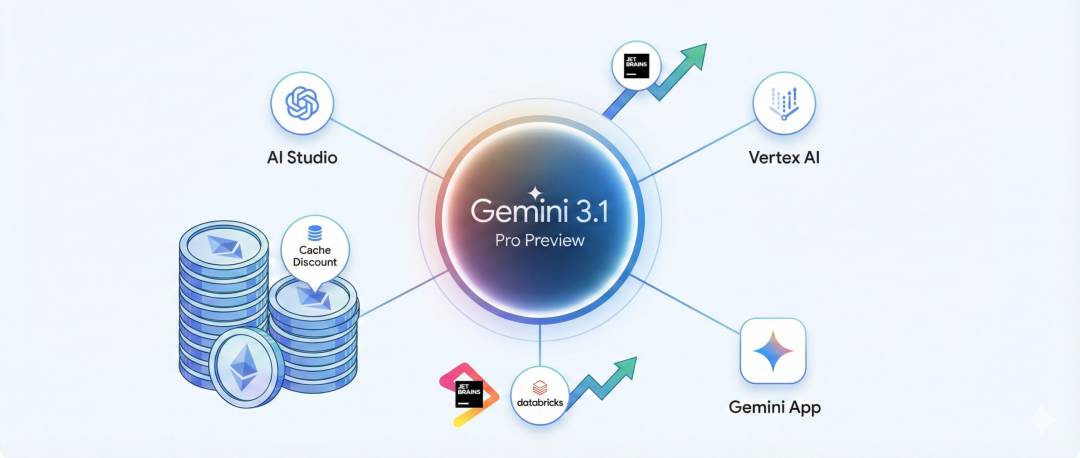
可用性: 3.1 Pro 目前处于预览阶段(Preview),已全面接入 AI Studio、Vertex AI、Gemini App、NotebookLM 和开发工具中。“预览版即是新的正式版”,各大厂商都在用这种方式抢占市场。
消费者订阅体系: 细分出 Free、AI Plus、AI Pro、AI Ultra 四个档位(最高档 Ultra 每月 $249.99,包含 Deep Think 模式和各种高级视频/图像生成权限)。
开发者API定价: 输入大约 $2–$3.60/百万Token。但重点是上下文缓存(Context caching)折扣,缓存后输入仅需 ~$0.20–$0.36/百万Token,极大地降低了重复性生产环境的成本。
早期客户反馈:
JetBrains: 响应更快、输出更精简、结果更可靠(性能提升达15%)。
Databricks: 在处理表格和非结构化数据的基准测试中表现出众。
Cartwheel: 在极度考验空间理解能力的 3D 变换理解上取得巨大进步。
💡 总结与行业洞察 (Conclusion)
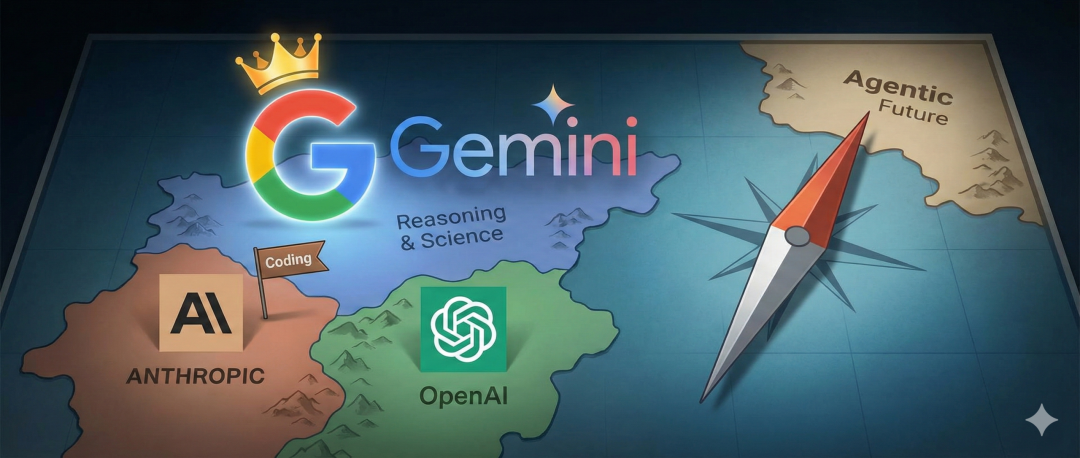
2026年2月当前AI前沿战场的全景图:
格局重塑: 谷歌目前在“推理 (Reasoning)”和“科学 (Science)”领域夺得了王冠;Anthropic 在“代码 (Coding)”上仍然保持着微弱的领先(零点几个百分点);而 OpenAI (GPT-5/5.2) 面临着来自两家强有力的前后夹击。
赛道变迁: AI 的能力衡量标准正在发生范式转移。一年前甚至不存在的测试(如 BrowseComp、APEX-Agents)现在成为了核心焦点。模型是否具有执行力(Agentic capability),成为了各大实验室比拼的下一个制高点。
谷歌的蜕变: 在经历了此前几次稍显被动的追赶后,Gemini 3.1 Pro 在短短三个月内实现 ARC-AGI 从 31.1% 到 77.1% 的跨越,证明了谷歌庞大的研发底蕴和新路线(Deep Think 技术下放)的巨大成功。