 宇宙纪事
文章 · 2026.02.20
【简报】2026年2月全球闭源大模型竞争格局
Kocher周 · 2026.02.20 · 原载微信公众号「可荐」
截至2026年2月,全球闭源大模型市场已进入“周迭代”的极速竞争期。竞争核心已从简单的“单轮对话智能”演进为三大主线:代理化(Agentic)长链路任务执行、超长上下文与多模态原生理解、以及可控的推理/成本/延迟平衡。
执行摘要
截至2026年2月,全球闭源大模型市场已进入“周迭代”的极速竞争期。竞争核心已从简单的“单轮对话智能”演进为三大主线:代理化(Agentic)长链路任务执行、超长上下文与多模态原生理解、以及可控的推理/成本/延迟平衡。
本次简报聚焦“四大金刚”的最新动态:Google Gemini Pro 3.1(主打多模态原生与科学推理)、Anthropic Claude 4.6(专注百万级上下文与递归推理)、OpenAI GPT-5.3(以Codex形态实现的硬核代理与实时交互)以及xAI Grok 4.2(依托社交实时数据与多代理共识架构)。市场趋势表明,企业正在从“模型崇拜”转向“动态路由网络”架构,将安全、合规与投资回报率(ROI)视为选型的核心维度。
一、 核心发布时间线(2026年2月)
2026年2月呈现出极度密集的发布节奏,厂商之间通过快速迭代实施“领跑-挑战”的心理战:
日期 (PT) | 厂商 | 版本/事件 | 关键核心内容 |
02-02 | OpenAI | Codex App | 强化并行工作流与多代理自动化的产品形态。 |
02-05 | Anthropic | Claude Opus 4.6 | 针对代理规划与复杂知识工作,首次引入1M上下文Beta。 |
02-05 | OpenAI | GPT-5.3-Codex | 强调SWE-Bench Pro、OSWorld等代理基准。 |
02-12 | OpenAI | Codex-Spark | 研究预览版,吞吐量 >1000 tokens/s,主打实时编码。 |
02-17 | Anthropic | Claude Sonnet 4.6 | Sonnet成为默认模型,提供自适应思考模式。 |
02-17~18 | xAI | Grok 4.2 Beta | 公测版本,强调“快速学习”与真值导向。 |
02-19 | Gemini 3.1 Pro | 深夜发布,2倍推理提升,新增代理流customtools端点。 |
二、 “四大金刚”深度解析与竞争定位
1. Google Gemini Pro 3.1:多模态原生与科学推理
- 战略定位:
作为Google Cloud、Workspace与Android的通用AI层,主打“云+办公+终端”的一体化协同。 - 核心突破:
- 推理跃升:
采用“Deep Think”架构,ARC-AGI-2成绩达77.1%,是前代推理性能的2倍以上。 - 思考分层:
引入 thinking_level参数,允许开发者在“直觉响应”与“深度思维链”之间选择“中等思考”阈值,平衡成本。 - 原生多模态:
能够解析4K 30fps视频流,并支持将抽象意图转化为SVG动画或3D打印文件。 - 长上下文优势:
默认支持1M输入,通过“上下文缓存”大幅降低重复查询成本。
2. Anthropic Claude 4.6 系列:百万上下文与自治代理
- 战略定位:
标榜“最安全、最可靠的高端企业模型”,强调合规与审计能力。 - 核心突破:
- 递归推理 (RRR):
打破线性生成模式,模型在输出前会自主分配计算资源进行多分支逻辑验证与自我纠错。 - 记忆极限:
1M上下文窗口在MRCR v2测试中召回率达76%,远超竞品;引入“上下文压缩”应对记忆腐败。 - 智能体编队 (Agent Teams):
能够自主拆解宏大项目,组建协作网络处理数据库迁移、前端重写等并行任务。 - 安全标准:
首个以ASL-3标准发布的模型,提供数据驻留(Inference_geo)控制。
3. OpenAI GPT-5.3 (Codex):实时交互与软硬协同
- 战略定位:
将ChatGPT打造为“AI操作系统”,通过AgentKit与Apps SDK深耕开发者生态。 - 核心突破:
- 训练栈融合:
首次将Codex代码栈与GPT-5通用栈深度融合,使其具备全域业务理解力。 - Spark破局:
与Cerebras合作,在WS-3晶圆级芯片上运行,实现>1000 tokens/s的吞吐量,主打“实时可中断”的工作流。 - 硬件共振:
将NVIDIA GB200系统的协同效能写进竞争叙事,强调推理栈的物理极限优化。 - 网络安全:
首个在Cyber CTF中被划定为“高能力”级别的基础模型。
4. xAI Grok 4.2:多智能体共识与实时数据
- 战略定位:
依托X平台与Tesla生态,主打“极致性价比”与“真值导向”。 - 核心突破:
- 四元智能体 (4 Agents):
内部由四个独立智能体并行推演,强制进行共识聚合,将幻觉率削减65%。 - 实时数据霸权:
深度整合X平台动态流,在金融实盘演算中回报率达12.11%,优于同行。 - 信任评分机制:
模型会实时监控自身逻辑并输出“信任分数”,主动承认逻辑混乱。 - 规模雄心:
预告2026年内发布6万亿参数的Grok 5。
三、 核心基准测试性能对标
2026年的评测体系已从MMLU转向代理型与长链路基准:
基准测试项目 | Gemini 3.1 Pro | Claude 4.6 (Opus) | GPT-5.3 (Codex) | 评测维度 |
ARC-AGI-2 | 77.1% (Deep Think 84.6%) | 68.8% | 52.9% | 抽象逻辑推理 |
SWE-Bench Verified | 80.6% | 80.8% | 80.0% | 真实代码修复 |
GPQA Diamond | 94.3% | 91.3% | ~92% | 博士级科学问答 |
Terminal-Bench 2.0 | 68.5% | 65.4% | 77.3% | 终端操作/代理编码 |
OSWorld-Verified | 数据未披露 | 72.7% | 64.7% | 计算机操控 |
Humanity's Last Exam | 44.4% (无工具) | 40.0% | 数据未披露 | 复杂人类测试极限 |
四、 商业模式与定价策略
市场已形成明显的分层定价,厂商正在“向上做平台,向下卷价格”:
模型系列 | 输入价格 ($/MTok) | 输出价格 ($/MTok) | 核心订阅/计划 | 商业特色 |
Gemini 3.1 Pro | $2.00 - $4.00 | $12.00 - $18.00 | AI Ultra: $249.99/月 | 依靠上下文缓存实现长文本低价复用。 |
Claude 4.6 (Opus) | $5.00 (长文本 $10) | $25.00 (长文本 $37.5) | Claude Max: 100-200/月 | 高溢价换取高合规性与递归推理。 |
GPT-5.3 (Codex) | ~ $6.00 (参考) | ~ $30.00 (参考) | ChatGPT Pro: $200/月 | 订阅制为主,深度集成IDE与CLI。 |
Grok 4.1/4.2 | $0.20 - $3.00 | $0.50 - $15.00 | SuperGrok Heavy: $300/月 | 价格屠夫,输入成本仅为竞品的1/10。 |
五、 安全、对齐与合规
随着代理模型获得物理环境操作权限,安全策略已从“内容过滤”升级为“执行治理”:
- 代理执行治理:
Anthropic公开承认Computer Use带来的提示词注入风险,并推进ASL-3分级防御。 - 高能力部署策略:
OpenAI对GPT-5.3启用Preparedness Framework中的“High Capability”谨慎部署模式,限制高风险网络安全任务的访问。 - 数据主权:
Claude 4.6提供“数据驻留”参数,允许企业指定推理地理位置;Google Vertex AI则强调个人数据处理附录。 - 监管风险:
Grok虽然通过了SOC 2等认证,但其在开放社交场景下的输出稳定性仍受质疑,需进行严格灰度评审。
六、 企业与创业者战略建议
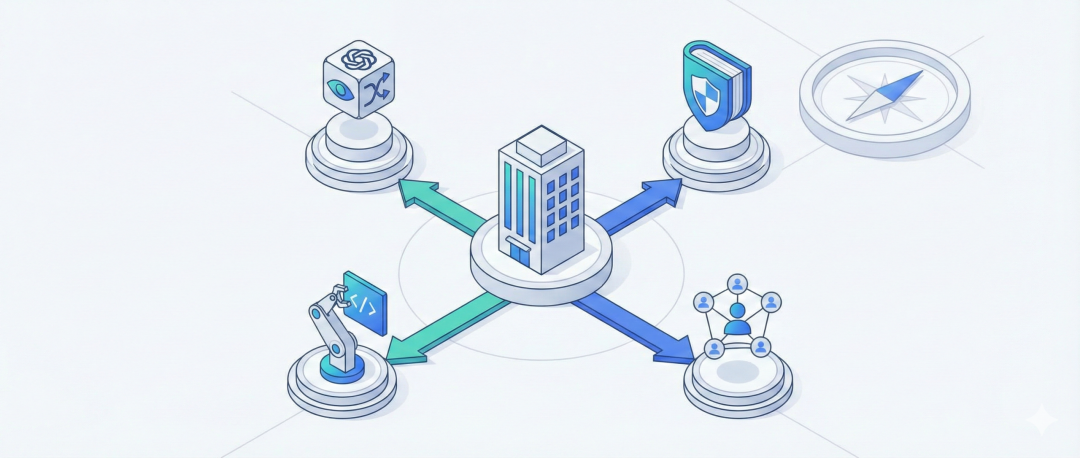
1. 企业选型建议
- 构建动态路由:
不要押注单一模型。建议采用“OpenAI/Gemini处理高端通用任务 + Claude处理高合规场景 + Grok处理高频低值任务”的架构。 - 指标转换:
选型不应只看名气,需建立内部“任务簇”评测,重点考察长上下文保持能力与多模态理解。 - FinOps 治理:
鉴于“思考Token”和“长上下文溢价”会导致账单剧烈波动,必须引入模型成本度量工具。
2. 研发与创业建议
- 深耕“代理工作流”:
别在通用聊天领域竞争,应利用Gemini/Claude的结构化输出能力,将不可控的语言输出转化为可验证的生产工件(如PR、合规报告)。 - 利用长上下文红利:
针对企业文档库和大型代码库,研发专属的缓存与压缩策略,建立垂直领域的壁垒。 - 保持模型可替换性:
鉴于目前“三个月一领风骚”的迭代频率,系统架构应默认支持多模型快速切换与回放评测。
报告编制: 2026年2月20日 数据截止: 2026年2月19日深夜