 宇宙纪事
文章 · 2026.06.25
【全栈尽头】OpenAI 与博通联手造芯成功, 但供应链的尽头是一座岛
Kocher周 · 2026.06.25 · 原载微信公众号「可荐」
首颗自研推理芯片 Jalapeño 问世, 2026 年底起将向千兆瓦级数据中心铺开
二〇二六年六月二十四日,旧金山与帕罗奥图之间的某个房间里,一片硅被郑重地交到了两个人手上。
交付者是博通(Broadcom)的总裁兼首席执行官陈福阳(Hock Tan),以及半导体解决方案集团总裁查理·考瓦斯(Charlie Kawwas)。接过它的,是 OpenAI 的萨姆·奥特曼(Sam Altman)与总裁格雷格·布罗克曼(Greg Brockman)。这片硅有一个会让人会心一笑的名字——Jalapeño,墨西哥辣椒。
这是 OpenAI 历史上第一颗属于自己的芯片。在官方的措辞里,它被称为一款专为大模型推理而生的「智能处理器」。对一家以软件、以模型、以那个名叫 ChatGPT 的产品定义了一个时代的公司而言,亲手造出一片硅,意味着它的全栈版图终于合拢——从芯片架构,到推理核函数,到内存系统,到网络,到调度,到部署,直到最终用户看到的那一行回答,每一层都收进了自己的掌心。
这是一个足够性感的故事。但本文想算的,是另一笔账。
因为当我们把镜头从那个交付的瞬间拉远,会看到一个更冷的事实:这颗辣椒从一张设计图,变成一片真正能跑模型的硅,再变成一座吉瓦级数据中心里嗡嗡作响的算力,中间要穿过一道又一道极其狭窄的门。而这些门的尽头,几乎全部通向同一个地方——一座岛。
一、一颗辣椒的来历:从 Titan 到 Jalapeño |
先把事实摆正,因为这件事容易被讲成一个「OpenAI 一夜之间变出一颗芯片」的神话,而它不是。
Jalapeño 并非凭空降生。早在二〇二五年十月十三日,OpenAI 与博通就已正式宣布一项战略合作——共同开发并部署约十吉瓦(GW)由 OpenAI 设计的定制 AI 加速器。在那份协议里,分工写得清楚:OpenAI 负责加速器与系统的设计,博通负责把它实现、量产、并用以太网技术把它们连成集群,部署计划从二〇二六年下半年启动,延伸至二〇二九年底。当天博通股价盘前一度跳涨约一成,英国《金融时报》估算,这笔合作可能耗费 OpenAI 三千五百亿到五千亿美元之巨。
再往前追溯,二〇二五年九月博通的财报电话会上,陈福阳曾透露签下了第四家定制 XPU 客户、拿下一笔逾百亿美元的机架级系统订单——业界几乎一致认定,那个神秘客户就是 OpenAI。换句话说,这颗辣椒在被端上桌之前,已经在锅里炖了将近一年。
在媒体此前的报道里,这个项目长期以代号「Titan」示人。Jalapeño 是它最终的商用名。所以那些把「Jalapeño」当成横空出世的新词来惊呼的稿子,其实只是没认出它的旧脸。
真正在背后操刀这颗芯片的,是 OpenAI 的硬件负责人理查德·何(Richard Ho)。他二〇二三年十一月加入 OpenAI——入职第一周,恰好撞上奥特曼被董事会突然解雇的那场风暴。在此之前,他在谷歌待了近九年,是谷歌云 TPU 项目早期的核心工程师之一与高级工程总监;离开谷歌后还曾在光子计算公司 Lightmatter 任硅与软件高级副总裁。截至发布时,他麾下的芯片团队据报已扩张到约四十名工程师。换言之,这颗辣椒的辣味里,本就掺着一股浓重的谷歌 TPU 血统。
辣椒被交到奥特曼手中
至于那个被反复传颂的「九个月」纪录——从最初设计到制造流片仅用九个月,OpenAI 称这是「我们所知高性能先进半导体领域有史以来最快的 ASIC 开发周期」——这里必须留一个限定语。请注意官方的措辞是「我们相信」(we believe),这是一句公司自述,而非第三方认证。业界一颗从零设计的 ASIC,通常需要十八到二十四个月。OpenAI 把这个速度归功于软硬件的深度协同,以及——这是最值得玩味的一点——用自家的 AI 模型来加速芯片设计本身。工程样片如今已在实验室里稳定跑起了真实负载,其中就包括那款专为实时编码而生的 GPT-5.3-Codex-Spark(它原本运行在 Cerebras 的晶圆级引擎上)。
于是一个闭环成形了:服务用户的 AI 模型,反过来帮助设计运行下一代模型的硬件。布罗克曼把这套逻辑称作一个飞轮——更好的基础设施带来更高的计算效率,更高的效率支撑更强的训练与推理,更强的模型带来更好的产品,更好的产品带来更多用户与收入,再把收入投回下一代基础设施。他说,世界正在向一种「算力驱动的经济」转型。
这颗芯片的意义,从来不在于多快、多省,而在于它补上了 OpenAI 垂直整合版图里最后、也最坚硬的一块拼图——硅。当一家公司同时拥有模型与跑模型的硅,它就同时拥有了智能的上限与成本的底线。 |
二、解剖:一片硅要经过多少只手 |
「OpenAI 造芯片」这句话,其实是一种修辞上的简化。准确地说,OpenAI 设计了这颗芯片,而把它真正变成硅、变成板卡、变成机架的,是一条横跨太平洋的漫长产业链。让我们一层一层剥开它。
最上游,是 OpenAI 自己。它基于对大模型底层机制的理解,定义了芯片的架构、推理核函数、内存系统、调度逻辑与部署方式。它知道自己的模型在算什么、卡在哪、最重要的数据如何在芯片里搬运——这是任何通用加速器都无法替它回答的问题。
第二层,是博通。它负责把设计变成可量产的现实:硅的实现、电路板与机架系统的集成、高性能网络,以及那套能够规模化生产的体系。其中最关键的一块是网络——博通用它的 Tomahawk 以太网交换芯片把成千上万颗加速器连成一个有机的整体。今年三月量产、业界首款达到 102.4 Tbps 的 Tomahawk 6,正是这套平台规模化的底气所在。在 AI 集群里,单颗芯片再强也只是孤岛,能不能把它们高效地缝合在一起,往往才是决定上限的那道工序。
第三层,也是整条链上最不可替代的一环——代工。Jalapeño 由台积电(TSMC)以先进的 3 纳米(N3)工艺制造。根据 Tom's Hardware 依据晶圆照片所做的估算,它的计算芯粒接近 EUV 光罩的物理极限(约 840 平方毫米,光罩极限约 858 平方毫米),是一颗名副其实的「光罩级」大芯片——比市面上大多数推理加速器的计算裸片都要大得多,规模已经逼近训练芯片。封装内部,是一颗巨大的计算芯粒、若干 HBM 高带宽内存模块、一颗 I/O 芯粒,以及起结构支撑作用的填充裸片。
这里要插一句诚实的限定:HBM 模块到底是六颗还是八颗,不同媒体根据同一张照片数出了不同的数字(Tom's Hardware 数为六,TechRadar 数为八),官方至今没有披露。我们能确定的只是「不少」,具体数目仍是推测。
第四层,是先进封装。一颗计算裸片与一圈 HBM 怎么被严丝合缝地集成进同一个封装?靠的是台积电的 CoWoS 技术。记住这个名字,下一章它会成为整篇文章里最锋利的那把刀。
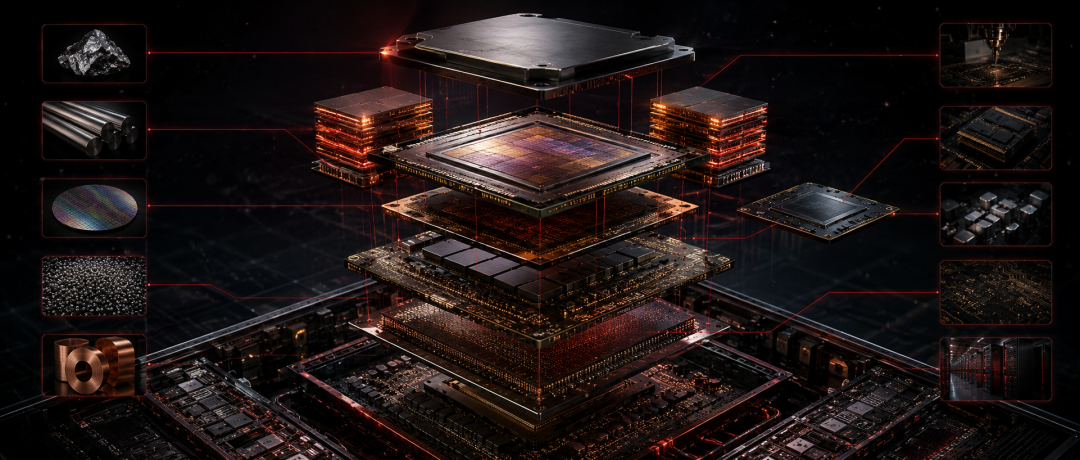
一片硅的供应链解剖图
第五层,回到地面:板卡、机架与整机系统的集成。主力是一家许多普通读者从未听说过的公司——Celestica(CLS)。它正是被这一轮 AI 浪潮彻底重估的「隐形冠军」之一。其二〇二六年第一季度营收四十亿五千万美元,同比增长达 53%;其中连接与云解决方案部门营收三十二亿四千万美元,同比暴增 76%,贡献了约八成营收,背后正是超大规模客户的 AI 需求。公司随后把全年营收指引上调至一百九十亿美元。一颗辣椒的辣,最终要靠这样一家做板卡和机架的公司,把它端到数据中心的餐桌上。
把这五层叠在一起看,一个朴素而冷峻的结论浮现出来:OpenAI 设计了大脑,但大脑要落地成血肉,必须依赖一条它并不拥有、也无法在短期内复制的物理链条。而这条链条上,藏着两个所有人都绕不过去的窄门。
三、两道窄门:CoWoS 与 HBM |
很多人以为,造 AI 芯片的瓶颈是晶圆产能——是台积电能不能多开几条 3 纳米产线。这个想法在二〇二六年已经过时了。真正卡住整个世界喉咙的,不是晶圆,是先进封装与内存。
先说封装。CoWoS 是把计算芯粒与 HBM 集成到一起的关键工艺,而它的产能长期处于「售罄」状态——CoWoS-S 与 CoWoS-L 的订单已经排到了二〇二六年甚至二〇二七年。据 TrendForce 与 Tom's Hardware 的数据,CoWoS 的月产能从二〇二四年的约三万五千片晶圆,升到二〇二五年的约七万五千片,二〇二六年底目标拉到十二万到十三万片——两年内扩张近四倍,却依然喂不饱需求。台积电先进封装部门的高管何军(Jun He)透露,二〇二二到二〇二六年间 CoWoS 产能的年复合增长率超过 50%。
问题在于,这块蛋糕被一家公司吃掉了大半。据摩根士丹利估算,英伟达(Nvidia)独占了约 60% 的 CoWoS 产能(约八十万到八十五万片晶圆),前三大客户合计拿走超过 85%。剩下那约 40% 的边角料,才轮到博通、AMD、Marvell、谷歌 TPU——以及现在的 OpenAI——去抢。这意味着,Jalapeño 哪怕设计得再惊艳,它能不能真正以吉瓦级的规模量产,第一道关卡不在 OpenAI,也不在博通,而在台积电的封装车间里,那条早已被英伟达占满的队伍。
再说内存。HBM 是另一道同样狭窄的门。二〇二六年的 HBM,整个行业已经卖光了。SK 海力士(SK Hynix)的首席财务官公开表示,公司「已经售罄整个二〇二六年的 HBM 供应」;美光(Micron)在二〇二六财年第一季度电话会上也称,其 HBM 产能「售罄至整个二〇二六日历年」。从市场份额看(二〇二六年初口径),SK 海力士约占 56% 到 57%,稳坐第一;三星(Samsung)约 22%;美光约 21%。三家瓜分了一个供不应求的世界。
那 OpenAI 的 HBM 从哪来?据路透社引述《韩国经济日报》的报道,三星计划在二〇二六年下半年向 OpenAI 供应至多八亿 Gb 的十二层 HBM4 芯片,用于其首款 AI 处理器,且 OpenAI 在三星 HBM4 的分配序列中排在第三位——仅次于英伟达和 AMD。但这里同样要钉一个限定语:这是单一来源、引述不具名业界人士的报道,三星拒绝置评,OpenAI 未予回应。下游一些博客把它夸大成「独家协议」,缺乏一手依据。它可信,但尚未被证实。
CoWoS 与 HBM:两道窄门
把这两道窄门叠加起来看,二〇二六年的图景近乎残酷。据 TrendForce 测算,这一年 CoWoS 的总需求逼近一百万片晶圆,而供给即便扩张到极限,也只有十二三万片的月产能;HBM 则整片整片地被提前锁定到日历年的最后一天。需求与供给之间的这道鸿沟,意味着每一颗想要规模化的 AI 芯片,都必须为封装产能而排队、而竞价、而等待。换句话说,Jalapeño 设计得再快——哪怕真是九个月流片——它要变成数据中心里真实的算力,时间表的真正主人也不在帕罗奥图,而在台积电的封装车间,和那三家内存厂的扩产节奏里。一颗芯片的命运,握在它根本无法控制的上游手里。
谷歌、亚马逊、微软、Meta、OpenAI 设计着五颗截然不同的芯片,却被卡在同样的两道窄门前——CoWoS 与 HBM。芯片的架构可以千差万别,但它们都要从同一条封装产线、同一批内存里诞生。差异化的设计,收敛于同质化的瓶颈。 |
四、一座岛:极致集中,与一份十万亿美元的账 |
现在,把所有的线索收拢到一个点上。无论是英伟达的 GPU,还是 OpenAI 的 Jalapeño,还是谷歌的 TPU、亚马逊的 Trainium、微软的 Maia、Meta 的 MTIA——这些设计迥异、阵营对立的芯片,最终都要在同一个地方诞生:台湾。
台积电生产着全球逾九成最先进的半导体,以及约 99% 用于训练前沿 AI 模型的芯片。这不是一个比喻,而是一个近乎垄断的物理事实。整个人类正在押注的「智能革命」,其物质基础几乎全部铸造在一座面积仅约三万六千平方公里的岛上。
而对这种集中,岛内看得无比清醒。经修订的《产业创新条例》设有一条「N-1」政策——台积电在海外部署的制程,必须至少落后岛内一代。这意味着最先进的 2 纳米(N2)与 1.6 纳米(A16)必须留在台湾岛内;亚利桑那工厂只被允许生产 3 纳米及更旧的节点;相关部门对海外扩张与合资握有否决权。这种极致的集中本身,就构成了一种微妙的处境——只要全世界最尖端的芯片都只能在这里造,那么台海局势的任何风吹草动,都会被瞬间放大成全球半导体供应链的剧烈震荡。
这是一把双刃剑:它让台湾地区在全球产业链上举足轻重,却也把整个世界绑上了同一条船。
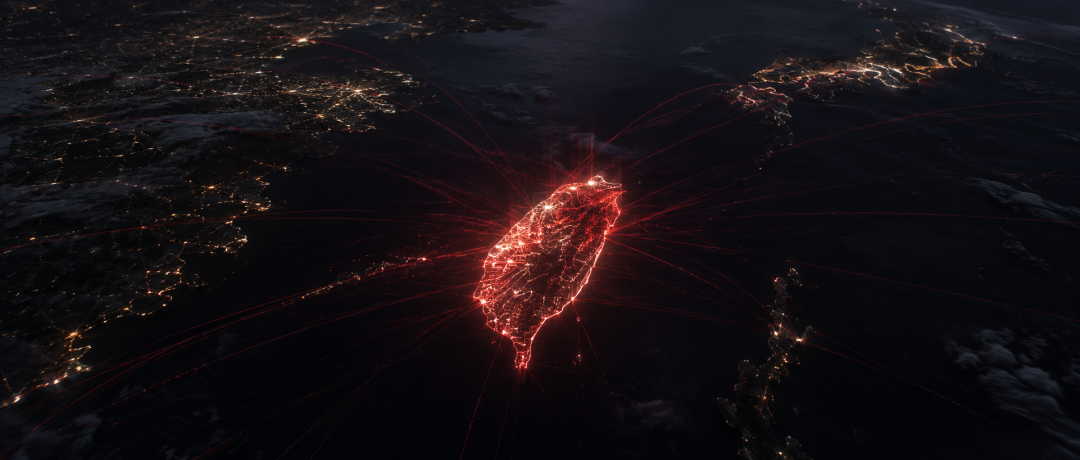
一座岛与它承载的全球算力
BLOOMBERG ECONOMICS · 2024 据彭博经济研究测算,台海局势一旦失稳,仅第一年,全球经济损失或将高达 10.6 万亿美元,约合全球 GDP 的 9.6%——超过新冠疫情,也超过 2007 至 2009 年的金融危机。 |
这个数字之所以惊人,不只是因为芯片断供。据美国战略与国际研究中心(CSIS)的资料,二〇二二年台湾海峡承载了超过全球五分之一的海运贸易;美国海军学会的报告则指出,当年全球近 48% 的集装箱船曾通过台湾海峡。一座岛、一条海峡,同时卡着全世界的算力与全世界的航运。当 OpenAI 的辣椒在这条链条上排队等待封装时,它排的其实是一条地缘政治的队。
而硅,还只是这条物理链上的一环。别忘了那个反复出现的单位——吉瓦。OpenAI 与博通的合作,从一开始谈的就是十吉瓦的部署规模。一吉瓦是什么概念?它约等于七十万到七十五万户美国家庭的全部用电。OpenAI 牵头的「星际之门」(Stargate)项目,二〇二五年一月由白宫站台发布,联合软银、甲骨文与 MGX,承诺四年投入五千亿美元;其德州阿比林(Abilene)旗舰站点满产将达 1.2 吉瓦,到二〇二五年底整个项目已规划七到八吉瓦、逾四千亿美元投资。奥特曼给出的星际之门加云承诺总额,约为 1.4 万亿美元。
这意味着,AI 的扩张不再只受制于硅,还受制于电、受制于地、受制于电网能否承载。当芯片要排台积电封装的队时,数据中心要排的是电力的队。一座岛卡着最先进的硅,而一整片大陆的电网,正被这些吉瓦级的胃口撑向极限。智能的物质基础,已经从一片小小的硅,延伸成了一整套关于能源、土地与电网的地缘账本——而账本上的每一个数字,都比上一个更触目惊心。
与此同时,半导体早已成为中美博弈的主战场。二〇二六年六月,台湾地区也在研究收紧对大陆的 AI 芯片输出,向美国看齐。中国大陆则宣布了一项约两千九百五十亿美元的国家级计划,要建设覆盖全国的 AI 数据中心网络,并以华为等国产芯片逐步替代英伟达与 AMD。在这盘棋上,每一颗定制芯片都不再只是商品,而是筹码。
而台湾的不可替代,短期内无解。新建一座前沿晶圆厂需要三到四年、上百亿美元;台积电亚利桑那工厂的 2 纳米量产,目标要到二〇三〇年。也就是说,在可见的未来里,全世界的 AI 雄心,都得继续在这座岛的阴影下排队。
五、不止 OpenAI:一张自研硅的全景图 |
OpenAI 不是第一个、也不是最后一个动手造芯的玩家。事实上,它是这场「去英伟达化」运动里最晚入场的巨头之一。要理解 Jalapeño 的位置,必须把它放进整张自研硅的版图里看。
谷歌是这场运动的祖师爷。它的 TPU 已经迭代了七代,最新的第七代「Ironwood」是其首款专为推理设计的芯片——同样由台积电 3 纳米制造,配备 192GB 的 HBM3E、7.37 TB/s 带宽,通过自有的 ICI 互连把 9,216 颗芯片连成一个 pod。谷歌不仅自用,还开始外售:与 Anthropic 的协议据报涉及至多一百万片 TPU。值得注意的是,Ironwood 的设计伙伴,正是博通。
亚马逊走的是 Annapurna Labs 自研路线。其 Trainium3 采用台积电 3 纳米,144GB 的 HBM3E、4.9 TB/s 带宽;为 Anthropic 打造的「Project Rainier」集群部署了五十万颗以上 Trainium2,并向百万颗扩展,仅印第安纳一处就规划了 2.2 吉瓦。Trainium4 已在路上,据报将支持英伟达的 NVLink Fusion——一种耐人寻味的「既竞争又共存」。
微软的 Maia 200(代号 Braga)同样是台积电 3 纳米、216GB 的 HBM3E、7 TB/s 带宽,二〇二六年一月起在爱荷华州部署,如今已开始服务 OpenAI 的 GPT-5.2 模型。微软与 OpenAI 之间这种「我用我的芯片跑你的模型、你又自己造芯片」的关系,本身就是这个时代最复杂的共生样本之一。
Meta的 MTIA 系列则从 7 纳米一路演进到 3 纳米,最新代际配备至多 288GB 的 HBM,已在内部部署数十万片,主攻推荐系统与生成式 AI 的推理与训练。它的设计伙伴,还是博通。
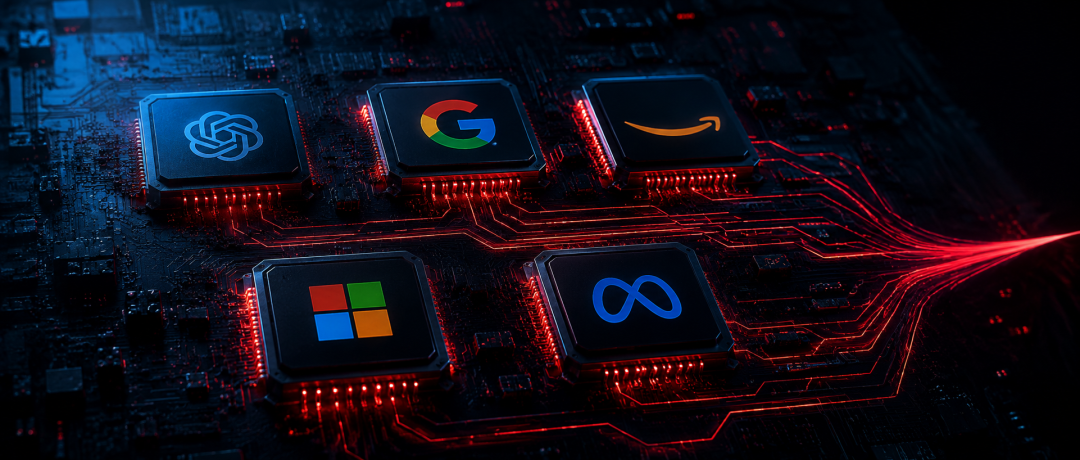
五大巨头的自研芯片矩阵
你或许已经注意到那个反复出现的名字了——博通。它是谷歌、Meta、OpenAI,乃至 Anthropic 共同的 ASIC 设计伙伴。连同另一家定制硅巨头 Marvell(它服务亚马逊 Trainium 与微软 Maia),两家公司合计控制了约 95% 的定制 ASIC 协同设计市场。换句话说,当这些超大规模厂商纷纷宣称要「自研芯片、摆脱依赖」时,它们其实只是把对英伟达的依赖,部分转移到了博通和 Marvell 身上。
而博通从中赚得盆满钵满。其二〇二六财年第二季度的 AI 半导体营收创纪录地达到一百零八亿美元,同比增长 143%;陈福阳预测全财年 AI 营收约五百六十亿美元,二〇二七年将突破一千亿美元,积压订单已超七百三十亿美元。今年六月,他亲口确认了六家定制芯片客户,并点名了 Anthropic、OpenAI、谷歌与 Meta。这场所有人都在造芯的盛宴里,最稳的赢家,或许不是任何一个造芯的人,而是那个帮所有人造芯的人。
六、英伟达的护城河,与一个正被改写的问题 |
说了这么多自研硅,那个房间里最大的影子——英伟达——还稳吗?
答案是:在训练领域,依然近乎垄断。凭借 CUDA 生态的深厚壁垒,以及 Blackwell、Vera Rubin 这样持续迭代的架构,英伟达仍握着约 70% 到 90% 的 AI 加速器市场份额。前沿大模型的训练,至今仍是它的天下——包括 OpenAI 自己,也在二〇二五年九月接受了英伟达至多一千亿美元的投资,并据此采购十吉瓦的英伟达系统。Jalapeño 是一颗推理芯片,它要替代的,是英伟达在推理环节的份额,而不是在训练上的王座。
但正在被改写的,恰恰是「推理」这道题。推理工作负载稳定、量大、可预测,是最适合用 ASIC 去压榨每瓦性能、每 token 成本的场景——而推理,已经占到 AI 算力的约三分之二。于是分析师预测,英伟达在推理市场的份额,可能从如今的 90% 以上,到二〇二八年降至 20% 到 30%。据 TrendForce 的数据,二〇二六年定制 ASIC 服务器出货占比预计达 27.8%,ASIC 出货同比增长 44.6%,约为商用 GPU(16.1%)的近三倍。
这就是 Jalapeño 真正的战略坐标:它不是要去英伟达的训练腹地决战,而是去切下推理这块正在迅速做大、且利润丰厚的市场。对一家每天要为数亿次 ChatGPT 回答买单的公司来说,哪怕只是把推理成本压下一截,乘以天文数字般的调用量,省下的就是真金白银。陈福阳对彭博社称这颗芯片能把推理成本降低约一半——不过要留意,这是博通 CEO 的口径,而非 OpenAI 官方;OpenAI 自己的措辞更克制,只说「每瓦性能将大幅优于当前最先进水平」,且详细技术报告要等「未来几个月」才发布。两种口径之间的温差,本身就值得读者保持一分清醒。
不过,唱衰英伟达还为时尚早。它真正的护城河,从来不是某一代芯片的性能,而是 CUDA——那套积累了近二十年、被全球开发者用成肌肉记忆的软件生态。定制 ASIC 再省,也有一个先天的窄处:它通常是为某一家公司的某一类模型量身定做的,灵活性远不及通用 GPU。Jalapeño 跑 OpenAI 自己的模型如鱼得水,但它不会、也不打算去跑别人的负载。这意味着 ASIC 的胜利,注定是「专用」的胜利,而非「通用」的取代。英伟达让出的,是那块标准化、可预测的推理蛋糕;它守住的,是前沿训练那片永远在变、永远需要灵活算力的疆域。这场仗更可能的结局,是分庭抗礼,而非改朝换代。
GPU 与 ASIC 的此消彼长
然而,无论 GPU 与 ASIC 如何此消彼长,有一个事实始终没变:所有这些芯片,几乎全部由台积电代工。无论英伟达赢还是 OpenAI 赢,无论训练胜还是推理胜——台积电都赢。它才是这场战争里真正的使能者,也是真正的终极瓶颈。当全世界都在讨论「谁的芯片更强」时,那个更冷的问题其实是:当所有人的强芯片都只能从同一座岛上长出来,这种「强」到底有多稳固?
七、垂直整合的悖论 |
让我们回到那个交付的瞬间,并把整篇文章的账,结在这里。
巨头们之所以前赴后继地造芯片,最初的动机非常清晰——逃离对英伟达的依赖,夺回算力经济学的定价权。垂直整合的叙事是诱人的:当你同时拥有模型与硅,你就掌握了从智能到成本的全部链条,再也不必把利润源源不断地交给那个卖铲子的人。
但本文一路剥下来的供应链,讲了一个相反的故事。它们逃离了一个依赖,却奔向了另一个更深、更不可控的依赖:同一个代工厂(台积电)、同一种封装(CoWoS)、同一种内存(HBM)、同一座岛(台湾)。垂直整合让它们摆脱了对一家芯片公司的依赖,却让所有人更紧地收敛到同一套物理基座之上。它们的芯片越是百花齐放,它们脚下的地基就越是同一块。
OpenAI 自己其实深谙此道。它的算力布局,是一套精心设计到近乎眼花缭乱的对冲。二〇二五年九月,它接受英伟达至多一千亿美元的投资、据此采购十吉瓦的英伟达系统(这笔交易被外界批评为「循环融资」);同年十月,它与 AMD 签约采购六吉瓦的 Instinct GPU,并拿到了按里程碑认购至多约一成 AMD 股权的权证;二〇二六年二月,亚马逊向它投资约五百亿美元,它则承诺在约八年内消费约两吉瓦的 AWS Trainium 算力;甲骨文那边,是一份约三千亿美元、为期五年的云合同;Cerebras 是一份逾百亿美元的多年期推理算力协议;软银则在二〇二五年底完成了对它四百一十亿美元的投资。再叠上自研的博通这一路——这套布局背后的逻辑只有一个:绝不把命脉押在任何单一供应商身上。
可问题在于:无论它把鸡蛋分到多少个篮子里,无论这些篮子贴着英伟达、AMD、博通还是 Cerebras 的标签,所有的篮子,在最深的那一层,都要经过同一座岛、同一条海峡。它对冲掉了供应商,却对冲不掉地理。
全栈的尽头,不是自由,而是更深的相互嵌套。当一家公司终于拥有了从模型到芯片的一切,它才会发现,那个它唯一无法拥有、也无法复制的东西,是地理。 |
一颗名叫辣椒的硅,被郑重地交到奥特曼手中。那是一个关于人类把智能的未来押注在一片硅上的隐喻。而这篇文章想补上的,是那个隐喻的下半句——那片硅,押在一座岛上。
这份账本的最后一行,写的不是 OpenAI,也不是博通或英伟达。写的是两个更古老的词:地理,与命运。在算力驱动的新经济里,最尖端的智能,依然要向最古老的地缘低头。Jalapeño 是一次漂亮的胜利,但它同时也是一张提醒——提醒这个沉醉于指数曲线的世界,曲线的脚下,踩着的是一块随时可能晃动的土地。
辣椒很辣。但真正让人后背发凉的,从来不是辣味本身,而是它背后那条窄得只容一座岛通过的供应链。而这条供应链的真正主人,至今仍不是任何一家硅谷公司。
本文综合 OpenAI 与 Broadcom 官方新闻稿(2026 年 6 月 24 日)、CNBC、Bloomberg、Tom's Hardware、TechCrunch、Reuters、TrendForce、CSIS 及 Bloomberg Economics 等公开资料整理。文中性能数字(每瓦性能、约 50% 成本下降、九个月流片)均为 OpenAI 与 Broadcom 单方声明或高管受访口径,截至发稿尚无独立第三方验证;部分供应链细节(HBM 模块数量、Samsung HBM4 供应、Microsoft 产能承诺)来源单一或存在冲突,已在文中逐处标注。
原文链接:https://openai.com/index/openai-broadcom-jalapeno-inference-chip/
转载请注明:《宇宙纪事 · 产业深度》系列。
宇宙纪事 / COSMIC CHRONICLES