 宇宙纪事
文章 · 2026.07.23
【震撼】黄仁勋摊牌:AI 的主战场不在互联网上
DEEP DIVE · NVIDIA AT SIGGRAPH 2026
Kocher周 · 2026.07.23 · 原载微信公众号「可荐」
DLSS 5、AI 物理模拟与 Cosmos 3 英伟达 SIGGRAPH 2026 主题演讲深度专研
一、语言模型只是开胃菜
2026 年 7 月 20 日,洛杉矶会展中心,第 53 届 SIGGRAPH。下午 3 点 45 分,英伟达的主题演讲开场。这一次站上讲台的不是产品经理,而是三位研究与工程负责人——黄仁勋只负责开场,把话筒交给做出 DLSS 的 Edward Liu、做 AI 物理的 Neil Ashton、执掌 Cosmos 实验室的 Ming-Yu Liu。这个安排本身就是一个信号:这不是一场卖卡的发布会,而是一场摊牌。
黄仁勋的开场讲了一个三十年的闭环。1993 年,英伟达为了解决传统计算机做不了的图形计算而创立;2001 年造出世界上第一颗可编程 GPU;2006 年推出 CUDA,把显卡变成科学与工程的并行处理器;2012 年,CUDA GPU 与 AI 完成「第一次接触」,为图形而生的处理器意外引爆了现代 AI;2018 年,就在 SIGGRAPH 的讲台上,RTX 发布,AI 反哺图形学。DLSS 1 的时代,每四个像素里有一个是推理出来的;今天,整片整片的屏幕区域都由神经网络生成。
但真正的落点在闭环之外。黄仁勋说,AI 将生成惊人的虚拟世界,而在这些虚拟世界里,AI 的下一个纪元——机器人——将会开始。语言大模型吃的是互联网上几十年攒下的文本;可机器人要学的抓取、避让、驾驶,互联网上没有现成的数据包。要训练能干实事的物理 AI,你需要海量的物理世界经验,而现实世界的时间按秒流逝,一小时路测就是实打实的一小时,极端场景的出现概率低到可以忽略。这就是整场演讲要解决的悖论。
|
" 在进入真实世界之前,机器人将先在虚拟世界里,用合成的经验完成学习。——黄仁勋 |
要造出这样一个「拥有真实物理规律的虚拟世界」,单靠代码写不出来,必须把计算机图形学、物理模拟和生成式 AI 熔在一起。于是整场演讲被拆成三块:DLSS 5 负责画面的真实,AI 物理负责规律的真实,Cosmos 3 负责把这两种真实合成一个可以无限试错的世界。我们按这个顺序,一块一块拆。
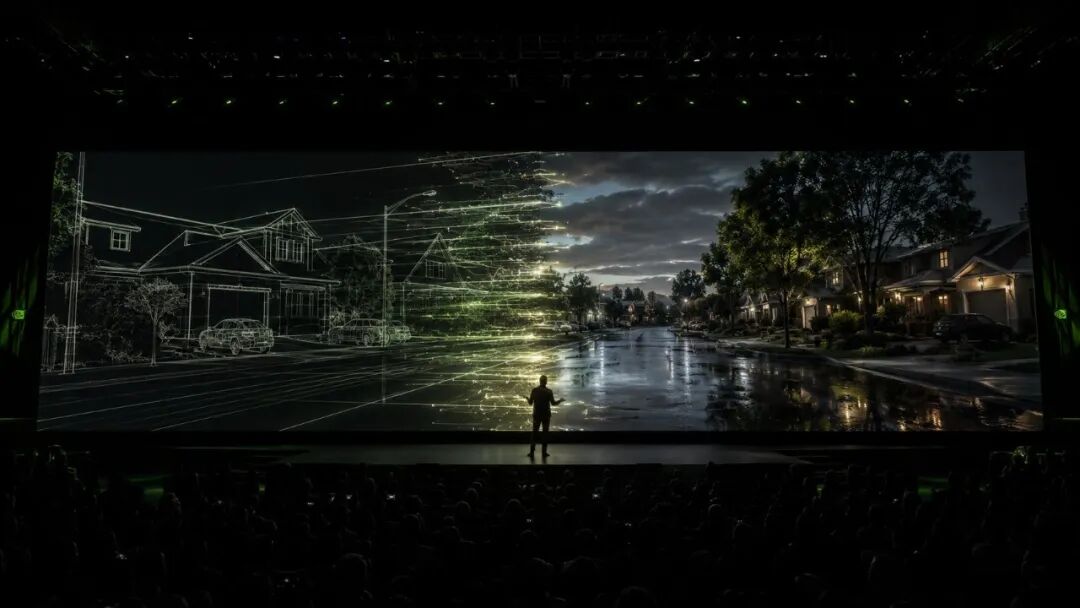
洛杉矶的摊牌时刻
二、DLSS 5:改变画面,不改变故事
先校准一个事实:DLSS 5 不是在 SIGGRAPH 上「横空出世」的。今年春季的 GTC 上,英伟达已经放出过惊鸿一瞥;SIGGRAPH 是它第一次完整的技术揭盅——它是什么、为什么这样造、今年秋天出货。但这不妨碍它的分量:Edward Liu 把它定义为实时渲染里 AI 的第三个类别。前两个类别我们早已熟悉:一是「重建」,DLSS 的超分与帧生成,任务是逼近资源无限时的完美渲染;二是「函数逼近」,用微型神经网络替掉昂贵的计算,比如神经辐射缓存、神经材质。第三类是全新的:生成。模型不再逼近某个既定答案,而是直接生成画面最终的样子。
逻辑起点是两个世界的互补。传统图形学从第一性原理出发:搭建场景,用物理定律模拟光线,再用精确到毫米的相机取景——每一个像素出现在那里,都是因为有人希望它在那里。这是渲染的骄傲,也是它的天花板:即便到了 DLSS 4 时代的全路径追踪,离「与现实无法区分」仍差一口气,因为次表面散射、复杂的光线穿透这些东西,硬算算不起。而另一边,生成式模型看过足够多的真实世界之后,早已学会皮肤如何散射阳光、逆光的发丝如何发亮、玻璃如何弯折它身后的世界——但它们庞大、缓慢,而且基于概率:你要一个黄昏下的商人,它给你一个绝美的商人;你再要一次,商人换了张脸。
DLSS 5 的答案:渲染器继续按游戏作者的意图构建世界,生成模型作为其后的「习得级」,只负责丰富外观。条件信号不是提示词、不是参考图,而是游戏刚刚渲染出来的那一帧本身——所有引擎普遍可得、信息密度极高、逐像素对齐。要把这件事做成,三座大山横在面前。
第一座,艺术意图。生成模型的天职就是改动画面,而每一次改动都可能偏离原意。Edward Liu 举的例子是一道疤:美术总监给主角脸上设定了一道疤,因为那是他的故事线;模型觉得这是瑕疵,顺手抹平——画面更干净了,角色却错了。解法是用渲染器的内部缓冲——反照率、表面法线、光照信息——训练模型死守底层的几何与语义,在红线之内自由发挥:疤痕可以获得更好的皮肤着色,但绝不许消失。
第二座,时间因果。视频生成模型的惯常做法是一次看一批帧、前后对齐了再生成。游戏不行:玩家鼠标一甩,下一帧是什么谁也不知道。好在引擎里有运动矢量,直接告诉模型物体在相邻帧之间如何移动。DLSS 5 由此做到了严格因果的逐帧生成——一帧进,一帧出,不偷看未来,而且不闪烁、不漂移、不游泳。
第三座,速度。一帧 4K 画面约 800 万像素,60 帧以上意味着每帧总预算不足 16.6 毫秒,其中大头还得留给游戏本身。而能生成照片级画面的基础模型动辄要花数秒。英伟达做了一次极限蒸馏:把大模型里关于世界外观的常识提取出来,压缩成一个单步、像素空间的扩散 Transformer。它继承了基础模型的全部世界知识——认得出角色、光照和语境——代价是失去了通用性。用 Edward Liu 的原话说,它再也不会生成搞笑猫咪视频了。
现场演示环节揭示了更关键的东西:控制权。DLSS 5 不是一个傻瓜开关,而是一整套导演台。开发者可以选择不同的底层模型——A、B、C,训练参数不同,成像风格各异,而且可以一个场景一个模型地混搭;「结构强度」滑块调制高频细节(环境光遮蔽、次表面散射、反射),「色调强度」滑块调制低频的光影氛围;因为模型理解画面语义,还能做「模型侧自动遮罩」——只对角色生效、环境不动;引擎侧则可以任意圈选:只强化这只水壶、这串葡萄、这几个酒瓶,滑块彼此独立。塑料感的酒瓶瞬间有了金属与玻璃交织的折射,旁边的环境纹丝不变。哪种真实、放在哪里、用多大力气——这些是艺术决定,属于做游戏的人,不属于模型。
|
" DLSS 5 必须以不改变故事的方式,去改变画面。——Edward Liu |
商业含义要拆开看。过去提升画质只有一根杠杆:堆渲染——更多光线、更高分辨率的纹理、更多三角形。DLSS 5 加上了第二根:堆模型。而且 Edward Liu 明确说了,即便不放大模型,仅仅是训练侧的改进——更好的数据、更好的损失函数——也会零成本地直接转化为运行时的画质提升。换句话说,玩家不换显卡、只更新驱动,画面真实度就能凭空跃升。画质的护城河从算力挪到了模型,而这套生成式渲染管线深度绑定英伟达的硬件生态——对手在传统流处理器上堆再多算力,也追不上管线末端「无中生有」的真实感。这是英伟达的阳谋。
诚实起见,两点保留也要写下。其一,DLSS 5 自 GTC 亮相以来在玩家社区遭遇过不小的负面声浪,「AI 味」的争议并未平息,SIGGRAPH 的这套艺术家控制体系,很大程度上正是对这种质疑的回应。其二,Edward Liu 自己承认:实时照片级真实尚未解决,动画的提升目前也远不及外观。曲线才刚开始爬坡——这话由推销者自己说出来,反而更可信。
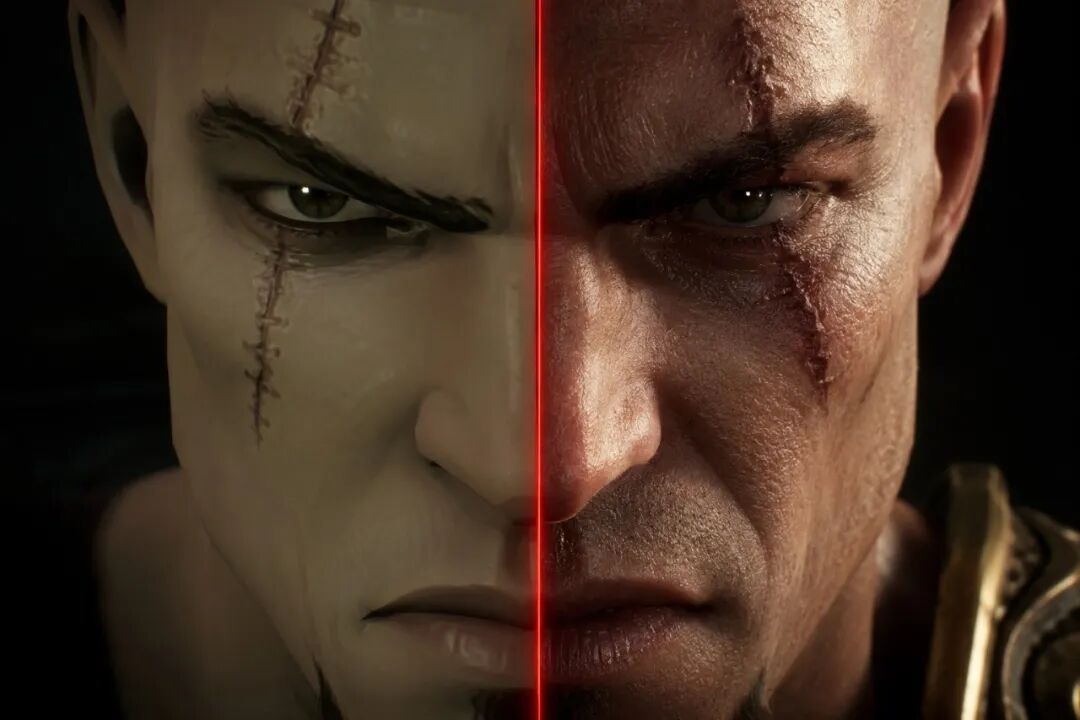
渲染的第二根杠杆
⁂
三、200TB 与 200MB:物理模拟的降维
画面的真实之后,是规律的真实。从英格兰飞来的 Neil Ashton——英伟达的杰出工程师、流体力学出身——开场放的不是游戏,而是一段地球气候模拟:超过两万张 GPU,1 公里分辨率,500 亿个网格单元,大气、陆地、海洋的耦合模拟,人类迄今对地球最精确的一次物理刻画,拿下了超算领域的戈登贝尔奖。这是传统数值方法的巅峰,也是它的困境的展品:把空间切成网格、按偏微分方程逐格硬算,网格越细、时间步越短,精度越高,算力需求也指数级爆炸。没有人能每天跑一次两万张 GPU。
于是灵魂拷问来了:AI 能不能帮忙。答案已经在气象界兑现。做法不是让 AI 背物理公式,而是像大语言模型吞文本一样,把四十年的 ERA5 再分析数据——经过观测校正的模拟数据——喂给机器学习模型,让它自己领悟大气运作的规律。结果是:过去要几小时、几天才能算出的天气预测,现在几秒到几分钟就能给出,精度持平甚至更高。这个结论最初遭遇过普遍的怀疑,如今怀疑已被彻底碾过——全球的气象中心已经把 AI 预测模型投入实际生产。在此之上还有 StormScope 这样直接用卫星与观测数据训练的模型,以快出数量级的速度预测风暴的合并与演进。
但 Ashton 半开玩笑地说,气象界其实占了便宜:地球的几何形状是固定的。真正的地狱难度,是给几何形状千变万化的工程世界做模拟——飞机、汽车、数据中心。他举了个所有坐过飞机的人都见过的例子:发动机短舱侧面那道不起眼的凸起翼片。空气是看不见的,你只能看见它的效果;只有高精度模拟才能揭示,这道翼片会在气流中划出一道涡旋,顺流而下打在机翼上,在起降时提供额外的升力。为了一个这样的设计决定,工程师要反复改形状、反复跑漫长的模拟,时间与算力成本都是天文数字。
然后是这场演讲里最惊人的一组数字。一个包含约 2,000 个飞机构型的公开数据集,每个高精度流体模拟超过 10 亿个自由度,总共生成约 200TB 数据。用英伟达研究院与合作机构开发的 Transformer 架构和 Token 化技术训练之后,模型检查点只有约 200MB——Ashton 特意强调这不是幻灯片上的笔误,模型是他亲手训练的。200TB 到 200MB,约一百万倍的压缩;拿它去预测一个训练中从未见过的全新几何形状与边界条件,在一张 RTX 6000 工作站显卡上,一秒钟出结果,与高精度模拟相比误差约 1%至 2%,预测速度快一万倍以上。相当于把 200TB 的流体力学知识提炼出了最核心的物理规律,塞进了一个 200MB 的文件里。
| AI 物理 · 关键数字 | 口径 / 说明 |
| 地球气候模拟 | 超过 2 万张 GPU · 1 公里分辨率 · 500 亿网格 · 大气/陆地/海洋耦合,获戈登贝尔奖 |
| 飞机气动数据集 | 约 2,000 个构型 · 单例超 10 亿自由度 · 合计约 200TB |
| 训练后模型体积 | 约 200MB 检查点,数据压缩约 100 万倍 |
| 未见构型推理 | 单张 RTX 6000 · 约 1 秒出结果 · 误差约 1%至 2% · 预测提速逾 1 万倍(提速与压缩是两个口径) |
这意味着工业设计的迭代节奏被彻底改写:过去是改一次设计、等几天出结果;现在是改一次设计、一秒钟知道行不行。设计师拖动汽车尾翼,风阻变化毫秒级反馈;散热工程师挪动机箱进风口,热流即时重算。Ashton 对台下的图形学专家们喊话:你们为好莱坞做水流与烟雾、发明可微物理与几何建模的这些本事,现在是时候带过来,一起推向电磁学与结构力学,加速下一代的科学与工程。当然,也要把边界写清楚:这类 AI 代理模型的定位是设计迭代的加速器,最终的适航认证与安全验证,仍然要回到传统高精度模拟与实验。它取代的是等待,不是标准。
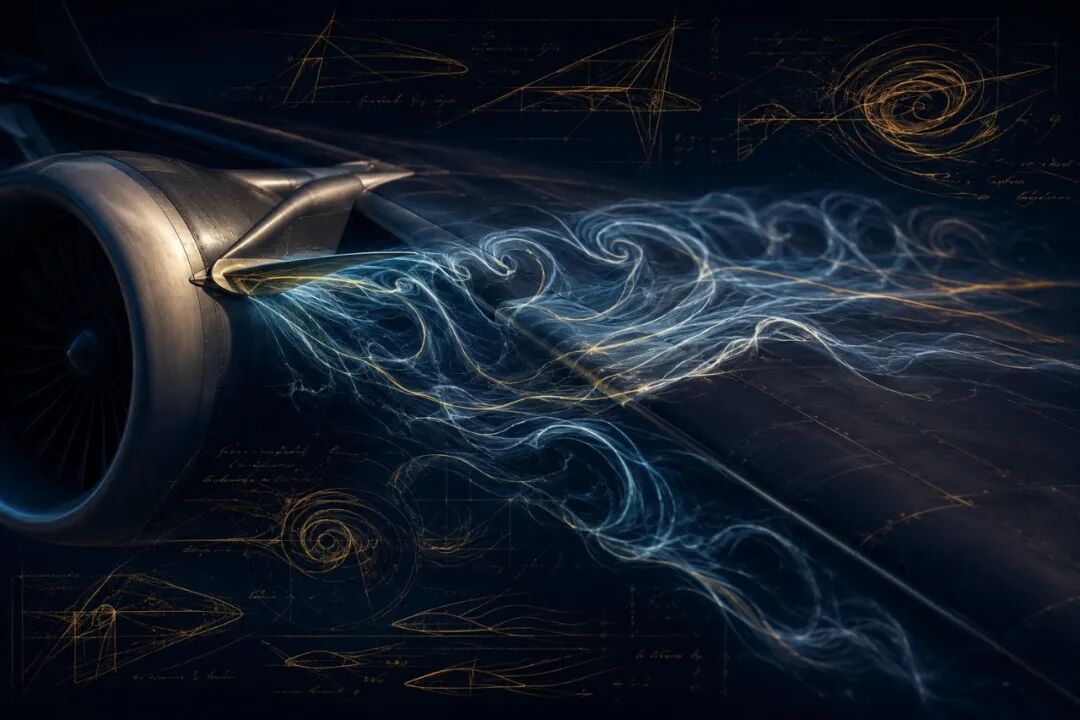
看不见的空气,看得见的涡旋
⁂
四、Cosmos 3:算力即数据
前两个板块——视觉的真实与规律的真实——都在为最后一块铺路。Cosmos 实验室副总裁 Ming-Yu Liu 上台,第一句话就戳穿了机器人行业的遮羞布:物理 AI 有一个数据问题。他把现有的数据来源逐一过堂:遥操作数据真实精准,但收集起来慢得令人发指;经典仿真可以规模化,但只覆盖你亲手搭建的场景;互联网用人类的眼睛看世界,不是机器人的。而现实世界只按实时运行——
|
" 你无法给现实按下快进键。——Ming-Yu Liu |
世界基础模型改变了这道算术题。如果有一个模型能从机器人的视角生成世界,数据就不再是「收集」来的,而是「计算」出来的:每一个 GPU 周期都在生成新场景、新变体、新测试用例——一千个厨房、一千个仓库、一千种天气,在机器人碰到真实世界之前统统跑一遍。这就是 Ming-Yu Liu 那句被打在屏幕上的话:对物理 AI 而言,算力即数据。世界模型是物理 AI 的数据引擎,机器人的能力从此随算力扩展。
Cosmos 3 的架构值得细看。它是一个开放的「全模态模型」,底层是全新的混合 Transformer 架构,两座塔并立:左边的自回归塔负责推理,做因果注意力,用语言思考它看到了什么;右边的扩散塔负责生成,产出视觉、音频与动作的 Token,每个 Token 关注全局,保证生成结果的整体连贯与物理正确。两座塔各有各的层归一化与 MLP,但共享一套多模态注意力——正是在这里,语言、视觉、音频与动作被对齐进同一套表征。为什么一套表征能通吃理解、预测、模拟、动作这么多任务?Ming-Yu Liu 的回答简洁得近乎哲学:因为我们只活在一个世界里,被同一套物理支配。
最核心的突破,是「动作」被扔进了神经网络,成为一等模态。麻烦在于每种机器人说的动作语言都不一样:汽车是转向,机械臂是伸展,灵巧手是抓握。英伟达的解法是建一套通用词表,把一切具身拆成三种几何基元:机身位姿(ego pose,身体在哪里)、执行器位姿(effector,手在哪里)、抓握状态(gripper,手在做什么)。自动驾驶汽车=一个机身位姿;单臂机器人=一个执行器加一个夹爪;人形机器人=一个机身位姿、两个执行器、两只手。而这套定义一旦确立,一件颠覆行业的事情随之发生:人类的第一人称视频也落进了同一套框架——一个机身位姿,两个执行器,两只手。有人戴着相机在厨房做饭,Cosmos 用逆向动力学看完,就能反推出每个动作背后的空间轨迹,把视频变成带动作标注的训练数据。互联网上浩如烟海的第一人称视频,一夜之间全成了机器人的教材。
在此之上,Cosmos 开箱即得三种物理 AI 建模:正向动力学——输入动作,预测后果,让模型在事情发生之前先把后果「演」一遍;逆向动力学——输入视觉变化,反推动作,是「视频变教材」的引擎;策略——输入视觉状态,输出该做什么与将看到什么。因果、归因与决策,三件事一个模型。按英伟达自己给出的口径,Cosmos 模型在横跨生成、推理与策略的八个基准上均排名第一——自家发布会上的自家榜单,参考价值有,独立复核也还需要时间。
|
KEY INSIGHT 语言 AI 的燃料是人类几十年攒下的存量文本;物理 AI 的燃料没有存量,只能被制造。谁能把算力转化为数据,谁就掌握了物理 AI 进化速度的阀门——这是 Cosmos 真正押注的东西。 |
模型家族分三档。上个月在 GTC 台北,英伟达发布了 160 亿参数的 Cosmos 3 Nano——每个物理 AI 团队做后训练的起点——和主打前沿保真度的 Cosmos 3 Super。SIGGRAPH 补上了最后一块拼图:Cosmos 3 Edge,40 亿参数,为一个目的而生——在设备端实时运行。机器人策略与视频分析直接跑在 Jetson Thor、RTX 与 DGX Spark 上,模型住在机器人住的地方,不再往返数据中心。现场演示里,一条机械臂和一个摄像头接在桌上那只灰色盒子——Jetson Thor 计算板——上,Edge 策略模型在本地吞下视频流、预测动作、实时控制机械臂完成任务,全程没有云端参与,没有网络延迟。这就是端侧物理 AI 的完全体:未来的机器人出厂自带小脑。速度问题也有专门的答案:Cosmos 3 Super 用分布匹配蒸馏把去噪步数压到 4 步,文生图与图生视频提速 25 倍,而按第三方 Artificial Analysis 的评测口径,质量仍处第一梯队。
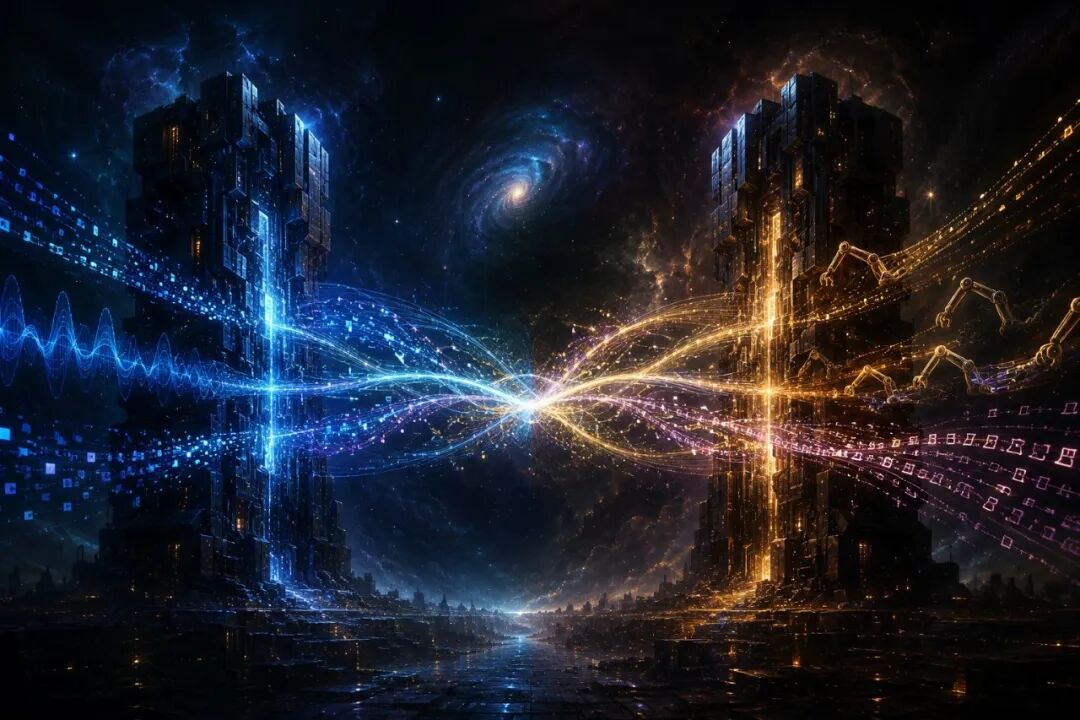
双塔之间的同一个世界
五、Dreams:从六十四张芯片到一张显卡
整场演讲的压轴,是建立在 OmniDreams 研究之上的新发布:Cosmos Dreams,神经闭环模拟器。第一个版本为自动驾驶而造:策略模型给出一个动作,Dreams 就根据这个动作,生成车辆传感器接下来将看到的一切——照片级真实、逐帧、以动作为条件、交互级速度。你的车,行驶在 Cosmos Dreams 的想象里。
现场的实机演示是这样的:屏幕上是一个阳光晴好的城郊街区,几辆车,几条车道,一切从单独一帧画面起步向外生成;演示者 Andy 手里握着一只 PS5 手柄,左转、右转、刹车,每个输入传给模型,模型按物理规律与光影逻辑实时算出挡风玻璃前该出现的下一帧——连右下角辅助模拟精度的鸟瞰图都是同步生成的。这不是录像回放,也不是游戏引擎,是一场毫秒级的、可以被方向盘改写的梦境。
最震撼的数字藏在算力履历里。按演示者的介绍,这套实时梦境刚做出来的时候,需要 64 张 GB300 级别的芯片并联才能跑动;随后优化到 16 张 Vera Rubin;而 SIGGRAPH 舞台上的这一场,跑在桌上一张 RTX 6000 工作站单卡上。一张单卡,跑起一整个物理世界。当算力成本被压到这个地步,自动驾驶与机器人研发的门槛就从云端跌到了车库:车企不必再把测试车开上街,把策略模型接进 Dreams,就能做无穷尽的闭环验证,专门生成现实里千金难求的极端场景——加塞、暴雨、鬼探头——而策略做出的每一次打轮,都会得到符合现实规律的反馈。
|
口径提示 关于这张单卡的具体型号,现场演示原话为「RTX 6000 Ada 世代工作站 GPU」,英伟达官方博客则写作「RTX PRO 6000」。两说并存,本文以「RTX 6000 工作站单卡」统称;「64 张 GB300」亦为演示者口径。核心事实不受影响:从数十张数据中心级芯片到一张工作站单卡。 |
Dreams 不是孤品,而是 Cosmos 这个平台复利的一环。自 2025 年 1 月问世以来的 18 个月里,Cosmos 一块块地搭:Predict 负责世界生成,Reason 负责世界理解,Policy 负责动作,到 Cosmos 3 全部收进一个全模态模型的身体里。英伟达自家的王牌都建在它上面:Metropolis 的视频分析、Isaac 的机器人训练、自动驾驶的旗舰策略模型、GR00T 人形机器人策略。Cosmos 3.5 已在开发,将补上多视角能力;模型、数据集、库与框架全部开放,Cosmos Coalition 的成员在贡献研究、数据与评测。这个开放姿态本身就是策略:模型开源开放,但生态的重心与最优的运行环境,始终落在英伟达的芯片上。
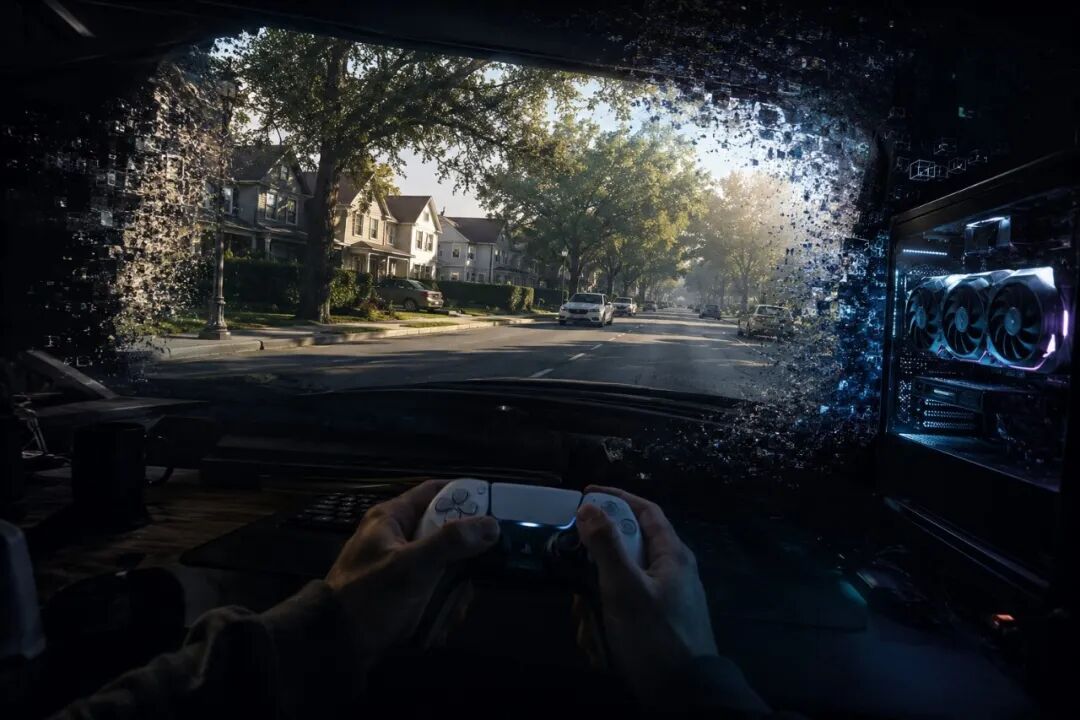
方向盘改写的梦境
⁂
结语:物理世界的新操作系统
把三个板块并排放好,这场演讲的底牌就完全翻开了。DLSS 5 把生成式 AI 拴进渲染管线,让画质的护城河从算力挪到模型;AI 物理把 200TB 的规律压进 200MB,让模拟的成本从超算跌到工作站;Cosmos 3 把两者合成一个可以无限快进的世界,让物理 AI 的数据从收集变成计算。三条线指向同一个位置:英伟达不再只是卖铲子的算力供应商,它在给数字与物理之间的整条通路铺设操作系统——给开发者算力,给工程师物理引擎,最后给机器人发放大脑。在这个新纪元里,不再是代码定义世界,而是生成式 AI 直接生成世界;未来的竞争,比的是谁构建虚拟世界的速度与保真度更高,因为那直接决定了物理 AI 进化的速度。
也要把另一面写全。这场演讲里最锋利的几句话,恰恰是承认局限的那几句:实时照片级真实尚未解决;动画的提升远落后于外观;八项基准第一出自自家口径;AI 物理代理加速的是迭代,认证仍归传统模拟。真正的分水岭也许不在技术,而在习惯——一旦开发者习惯了滑块代替着色器、单卡代替车队、生成代替采集,他们就再也回不去了。平台锁定从来不靠强制,靠的是让离开变得不可想象。三十年前,英伟达为图形造了一种新计算机;十四年前,这种计算机意外点燃了 AI;今天,AI 掉头回来,开始重写图形、模拟与机器人共同的地基。闭环走完了一圈,而圈的圆心,始终是同一家公司。
现实没有快进键,但现实的模型有。
本文依据 2026 年 7 月 20 日英伟达 SIGGRAPH 2026 主题演讲(Next Era of Graphics)写成,关键事实经演讲全文转录稿、英伟达官方博客及多家独立报道交叉核验;演讲者单方表述与自家基准均已在文中注明口径。成稿于 2026 年 7 月 23 日。
转载请注明:《宇宙纪事 · 深度专研》系列。
宇宙纪事 / COSMIC CHRONICLES